RSI,先会verify的模型先享受
今年Agentic Coding的进展速度丝毫没有减弱的趋势,2027毫无疑问是靠RSI比拼加速度的一年。
现有的RSI工作大部分都是基于可验证的任务,通过更新模型参数、修改Agent的harness把任务做的更好。然而实际的情况是,大部分真实任务是无法简单验证或打分的,因此要让模型基于反馈进行自我优化,验证能力是关键的一环。
在DeepSeek-V4.1-Flash-1017的博客[1]中,提到了通过「基于自反馈的强化学习训练技术」来提升许愿式编程的能力,Gemini 4 Carbon[2]也提出了「extended verification loops」这一概念。模型实际任务的完成效果,一定程度依赖它是是否能充分发现产物问题,并多轮改进。
那么应该如何提升模型的验证能力呢?
生成!=验证
第一个要认清的现实是,一个模型能生成理想的答案、做好任务,并不代表它有验证能力。
在ICML 2026的Learning to Self-Verify Makes Language Models Better Reasoners[3]中,作者设计了一个实验:基于同一个模型做Math RL,一组只练做题,答对了给奖励;另一组专门练判题,给它题目和一份它自己采样的解答,判对了给奖励。两组都训练1,000步,然后测试这两个模型的做题和判题能力。结论是:
- 只学判题的模型,比Base模型更会判题,做题准确率整体接近只学做题的模型,而且解题时的平均输出更短
因此,不能指望做题能力涨了,判题能力就跟着涨,模型的验证能力是需要单独进行优化的。
另外结论显示只训判题能提升做题效果,这是因为具备了更好的改正错误路径的能力吗?作者进一步做了一个实验:找了1,545道数学题,先让Qwen2.5-7B-Instruct写解题过程,再让GPT-4.1把这些过程改写成长度不一、带错的thinking prefix。给三个模型同样的题目和prefix,让它们接着思考。判题模型的最终答对率高于做题模型、Base模型,说明它更容易从带错的prefix走到正确答案。
验证的Loop
其实让模型具备验证行为不难,SFT都训这样的数据就可以了,难的是让验证有效,真正做好整个loop:
- 如果产物正确则继续进行;如果产物错误,模型能探索到正确的路径
实际上评估这个loop的好坏是非常难的,除了筛选出来loop行为的轨迹进行SFT外,在RL的时候如何对loop的过程给予有效反馈呢?
奖励验证行为
ReVeal(ICLR 2026,微软亚洲研究院、同济大学和中国科学技术大学)[4]主要在代码场景优化模型的验证行为,他们的思路是既给写对的单元测试奖励,也把下一轮修代码的进步算给前一轮的验证。
给定一道编程题,先让模型写代码,再让它针对这版代码写测试,包括输入和预期输出。训练时,执行器先拿参考实现跑这些测试,通过的才拿去跑模型写的代码。模型会看到预期输出、实际输出和报错,再根据这些信息写下一版。推理时参考实现不可用,执行器直接拿模型写的测试跑当前版本。
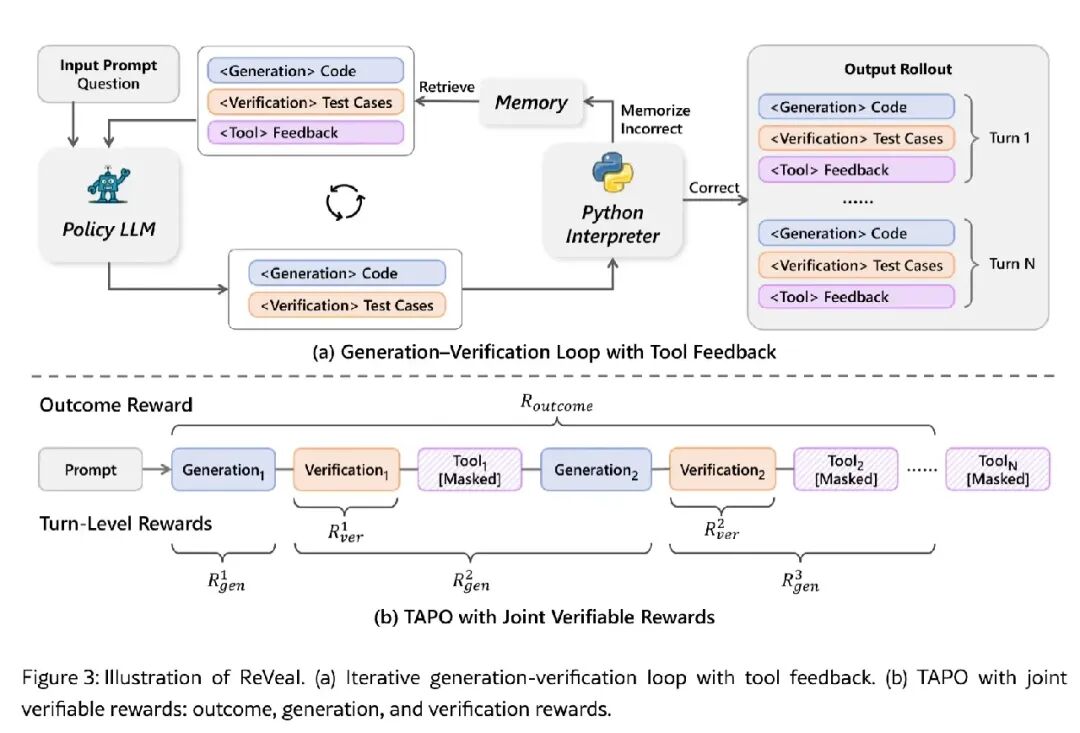
训练时有三种奖励:
- 看测试写得对不对。 模型写了几个测试,就按其中能在参考实现上通过的比例给分。这笔分给写测试的那一轮。
- 看代码改得好不好。 用题目自带的测试跑代码。第一版按通过率给分,之后按修改前后的通过率差值给分,改差了也扣分。前一轮写测试也拿到这笔分。
- 看最终代码能不能交。 最终版本的分是题目自带测试的通过率乘以5,再加格式分(格式对了加1分,错了扣1分)。一个测试能在参考实现上通过,只说明它的预期输出跟参考实现一致。它有没有帮到下一轮,得再看代码改完后的结果。
奖励好的修改
SCoRe(ICLR 2025,Google DeepMind)[5] 的思路是重点奖励模型第二轮正确的修改。
第一轮先直接让模型作答,第二轮把题目+解答,以及一条固定的检查指令交给同一个模型。让模型要自己看哪里可能有错,可以保留原答案,也可以改。第二轮作答时,模型看不到标准答案或测试结果。作者试过只用第二轮的正确性做RL,结果两轮的正确率都涨了,但两轮之间的正确率差基本没变,模型也越来越少改答案。因为两轮用的是同一个模型,给第二轮做 RL 时,参数更新也会影响第一轮。模型可以先把第一轮答得更好,第二轮沿用原答案,就能拿到分。
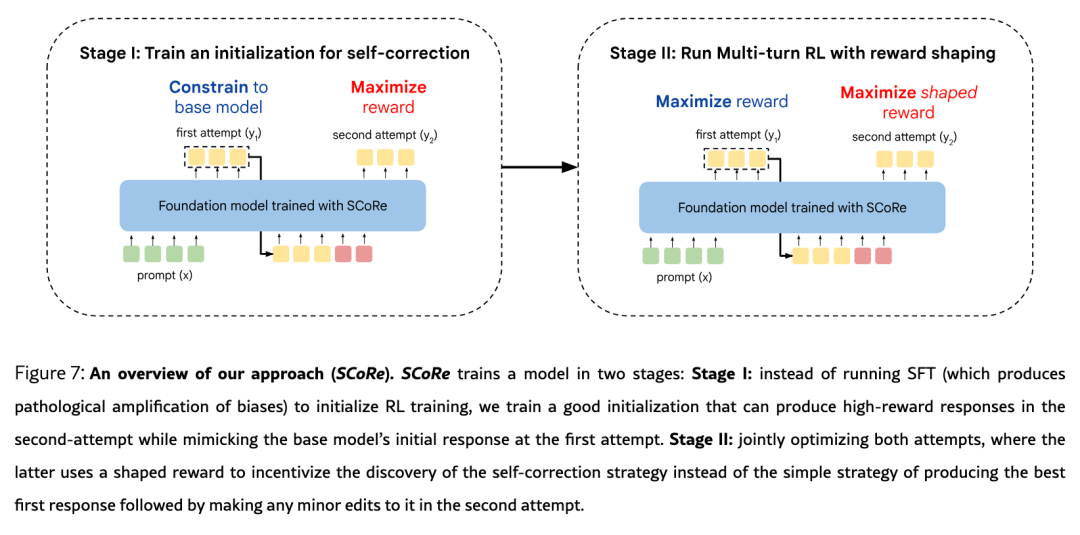
于是作者尝试了两阶段训练:
- 还是让当前模型做两轮。第一轮加一个较强的 KL 约束,让模型在看到题目时,作答倾向尽量接近训练前的模型。第二轮按答得对不对给奖励。这样训练时还能看到原模型会犯的那些错,第二轮就有机会练怎么改。更新的仍是同一套模型参数。
- 从第一阶段训练出来的模型继续训。每道题还是先答、再改。现在第一轮答对也有奖励,第二轮答对也有奖励。除此之外,第二轮再加上「第二轮的正确性得分减第一轮的正确性得分」乘上一个权重。错改对,加分。对改错,扣分。两轮同对或同错,这笔额外分都是零
奖励多样的探索
RepExp(ICLR 2026,普林斯顿大学和 Microsoft Research)[6]的思路是,除了奖励答对,也给同一批里比较不一样的解答一点奖励。
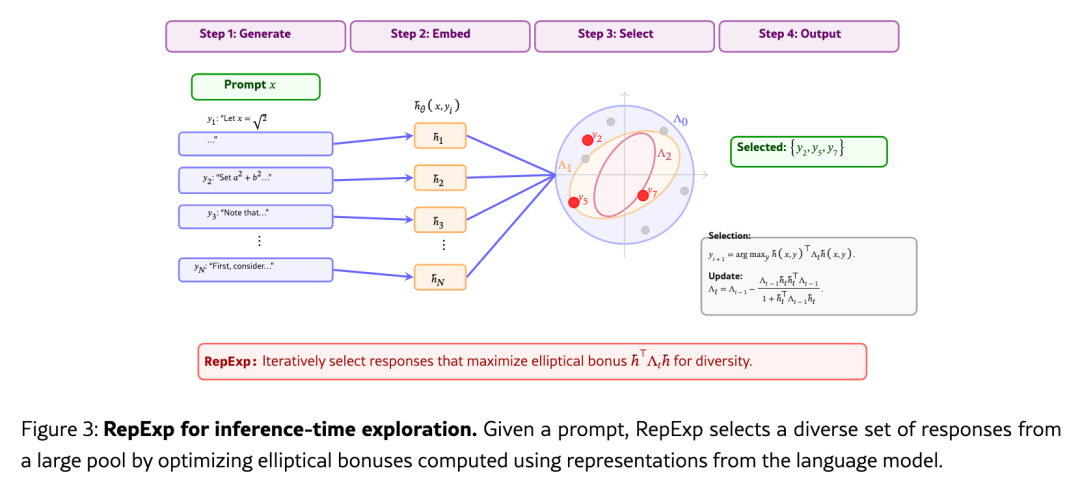
训练时,给模型一道题,让它独立采样一批解答。每份解答的输入都是原题,模型看不到其他解答,也收不到前一次的判题结果。作者给这些解答算两笔分:
- 答对的分。 验证器用标准答案判每一份解答,按原来的 GRPO 方法给正确性奖励。
- 探索的分。 用模型的隐藏表示来比较同一批解答。表示上越不一样,探索分就越高,答错的解答也能拿这笔分。这个实验看的是从原题多采样几次能不能答对,收到验证反馈之后怎么改是另一个问题。
总结
早在23年训Reward Model的时候就有了LLM-as-Judge、Self-Rewarding等方向,我也探索过一阵子,当时的一个愿望是模型的验证能力会随生成能力提升,这样模型就能左脚踩右脚突破人类Judge的上限。
但随着agent的发展,要优化的目标从单轮生成转为了多轮的trajectory,其实更贴近人类完成任务的过程。再进一步想,验证错了也没关系,只要能让下一步改得更好即可,在模型跟环境、用户交互的过程中,也需要根据context不断提升验证的正确性。
[1]DeepSeek-V4.1-Flash-1017: https://api-docs.deepseek.com/zh-cn/news/news261017/
[2]Gemini 4 Carbon: https://deepmind.google/models/model-cards/gemini-4-carbon/
[3]Learning to Self-Verify Makes Language Models Better Reasoners: https://proceedings.mlr.press/v306/chen26es.html
[4]ReVeal: Self-Evolving Code Agents via Reliable Self-Verification: https://arxiv.org/html/2506.11442
[5]Training Language Models to Self-Correct via Reinforcement Learning: https://arxiv.org/html/2409.12917v2
[6]Representation-Based Exploration for Language Models: From Test-Time to Post-Training: https://arxiv.org/html/2510.11686
「许愿RSI」
内容中包含的图片若涉及版权问题,请及时与我们联系删除