「万字长文」大模型异步 RL 框架的设计与权衡:从 Staleness 控制谈起
PSRL:面向 LLM 异步 RL 后训练的 staleness 可控框架
Github链接:
https://github.com/psrl-project/psrl
知乎链接:
https://zhuanlan.zhihu.com/p/2105466561272211209
Blog链接:
https://lhy101.github.io/blog
PKU-DAIR链接:
https://github.com/PKU-DAIR
随着大语言模型(LLM)的强化学习(RL)后训练越来越重要,如何高效地扩展 RL 训练系统,成为系统设计中的一个重要问题。为了提高 GPU 利用率和整体训练吞吐,越来越多的 RL 框架采用异步执行机制,将生成(rollout)和训练(training)解耦,使样本生成与模型训练能够并行推进,而不必严格同步等待。
然而,异步执行在提升系统效率的同时,也带来了一个问题:当生成的样本真正参与训练时,生成它的策略可能已经更新了多个版本。这种生成策略与训练策略之间的版本差异,通常称为 staleness(陈旧度)。
Staleness 越大,生成策略与训练策略通常越可能出现较大的偏离,样本也可能更加偏离当前策略的数据分布(即更具 off-policy 性),进而影响训练的稳定性与收敛表现。当然,具体影响还取决于 RL 算法和相应的校正方法。但无论如何,在提高系统效率的同时控制 staleness,都是异步 RL 框架需要面对的一大核心问题。
乍一看,这个问题似乎并不复杂。许多框架都提供了类似max_staleness 的参数。将它设置为1,或者放宽到3,似乎就能限制样本的陈旧程度,让 rollout 和 training 各自独立运行。但问题是,max_staleness=3究竟限制了什么?它真的能像我们想象的那样,保证所有参与训练的样本最多只落后3个策略版本吗?答案未必如此。
我们在梳理现有框架并通过实验验证后发现,严格控制 staleness 并没有想象中那么简单。一些看似能够限制 staleness 的机制,实际上仍可能让超出上限的数据参与训练。换言之,我们对某些参数作用的直观理解,与其实际能够提供的保证之间,往往存在一定差距。
事实上,现有能够真正保证 staleness 上限的方案,通常都需要引入一些不可忽视的开销。例如,直接丢弃超过 staleness 上限的数据。这样虽然能够确保超限数据不会进入训练,但也意味着此前为生成这些数据付出的计算资源被白白浪费,进而造成有效训练吞吐的明显损失。
那么,我们究竟该如何控制 staleness 呢?
本文围绕这个核心问题展开,先从一条 trajectory 的生命周期出发,解释 staleness 的来源与定义,再梳理现有框架的控制机制及其局限。在此基础上,我们将介绍一套我们研发的 staleness 控制协议,并通过实验考察它的效果。
RL 的一条轨迹(trajectory)通常从一个 prompt 开始。Prompt 是模型的输入,而 trajectory 则是模型基于该 prompt 生成的序列,由一个个 token 组成。在异步 RL 中,prompt 从数据集取出后,不一定会立即开始生成,系统通常需要先决定是否允许它进入 rollout。下文将这一动作统一称为准入(admission)。准入后,rollout 才开始生成 trajectory。生成完成后,结果通常会进入 queue 或 buffer,等待训练侧取样。
对于 GRPO,同一个 prompt 通常会生成多条 trajectory,组成一个 group。训练侧从queue/buffer中选出trajectory group,这个动作称为训练取样。选出的内容由 batch assembler 组装成一个 batch,也就是本轮一起参与训练的内容。
在异步 RL 中,rollout 端和 training 端可以同时处理不同的 trajectory。rollout 端继续生成时,training 端也在用之前收集的 batch 训练。因此,一条 trajectory 从开始生成到训练取样,可能经历多次策略版本更新。要准确描述它的 staleness,需要区分三个阶段:开始生成、生成完成后等待训练取样,以及被选入 batch 并参与训练。对于采用 partial rollout(允许一条 trajectory 使用多个版本拼接生成)的系统,还需要进一步区分同一条 trajectory 中不同 token 的生成版本。
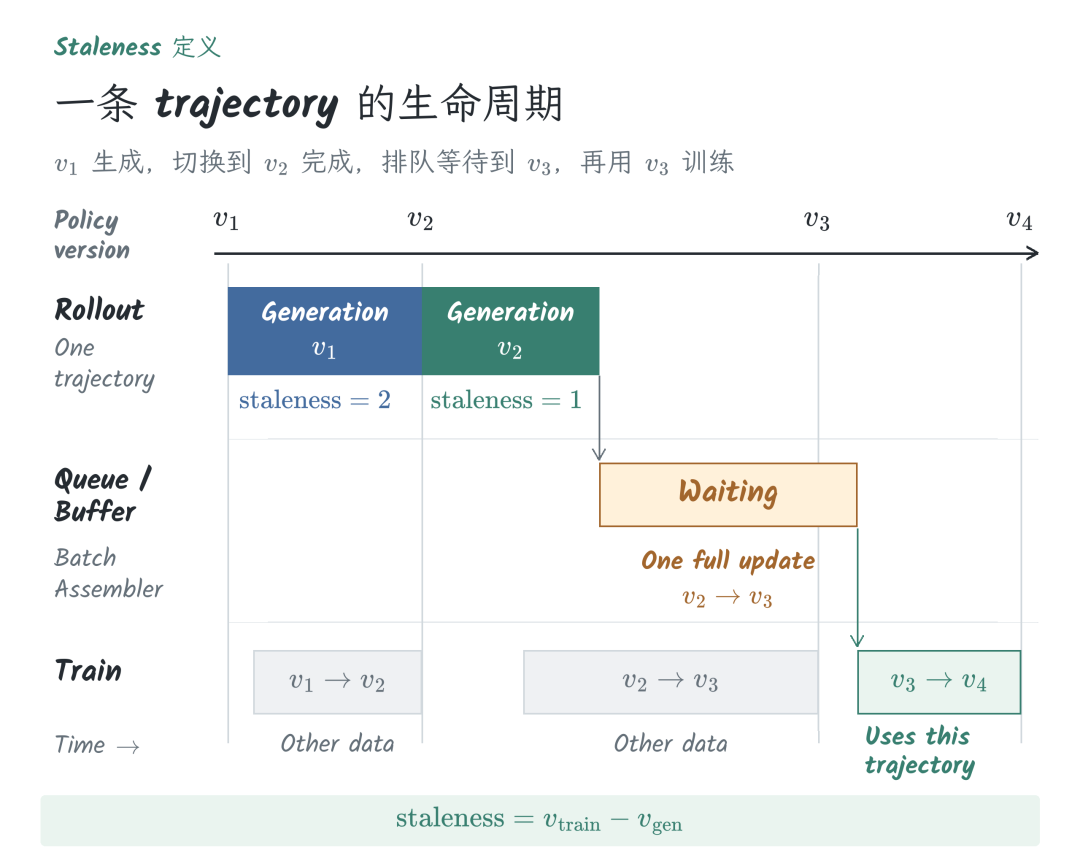
图 1:一条 trajectory 的生成、等待与训练
上图展示了一条 trajectory 的生命周期。它在模型版本 v1 时准入并开始生成。生成期间,训练侧完成一轮更新,得到 v2,并将新权重同步到 rollout 端。这条 trajectory 采用了 partial rollout:保留已经生成的前缀,再使用 v2 继续生成剩余部分。因此,同一条 trajectory 中可能包含由 v1 和 v2 分别生成的 token。
生成完成后,trajectory 也不一定马上参与训练。由于训练侧还在处理之前的 batch,它需要先在 queue 或 buffer 中等待。期间,训练侧继续从 v2 更新到 v3。直到训练侧使用 v3 时,这条 trajectory 才被取出并参与 v3 到 v4 的训练。
顺着上面这个例子,staleness(陈旧度)就容易理解了。对一个 token,训练版本减去生成版本,就是它的 staleness:
图中这条 trajectory 在 v3 时参与训练,所以前半段 token 的 staleness 是 3 - 1 = 2,后半段则是 3 - 2 = 1。
从这个例子中我们不难看出,staleness 的来源由两部分构成:生成时的 staleness 以及排队等待时的 staleness。生成时间长,或者生成后等待得久,都可能让 staleness 增加,因为这两段时间里,训练侧都可能继续更新,跨过数个策略版本。
如果要用一个数描述整条 trajectory 的 staleness,我们可以取 trajectory 中最大的 token staleness。因此,图中示例 trajectory 的 staleness 就是 2,因为最早用 v1 生成的那部分内容,在训练时落后了两个版本。而对于 GRPO 的一个 group,我们类似地取组内全部 trajectory staleness 的最大值,作为这个 group 的 staleness。
因此,本文将“严格控制 staleness”定义为:设定上限后,系统能够保证所有实际参与训练的 token,其 staleness 都不超过该上限。例如,上限为 3,就要求每个参与训练的 token,其生成版本与训练版本之差不超过 3。平均 staleness 较低,或只在部分负载下观测到的 staleness 没有超限,都不足以证明系统提供了这一保证。被取消或丢弃、最终没有参与训练的 trajectory 不计入这一判定。
基于上述定义,接下来我们将进一步考察现有异步 RL 框架的做法,并分析其能否有效控制住最大 staleness。
沿着 trajectory 的生命周期,我们观察到,系统其实可以在三个环节介入,来控制 staleness:(1)生成开始前,决定是否准入。(2)生成过程中,决定是否继续生成。(3)生成完成后,决定结果的排布顺序,以及结果能否最终进入训练 batch。不同框架的实现方式有所不同,但都可以归入这三个环节。下文分别将它们称为 L1、L2 和 L3。
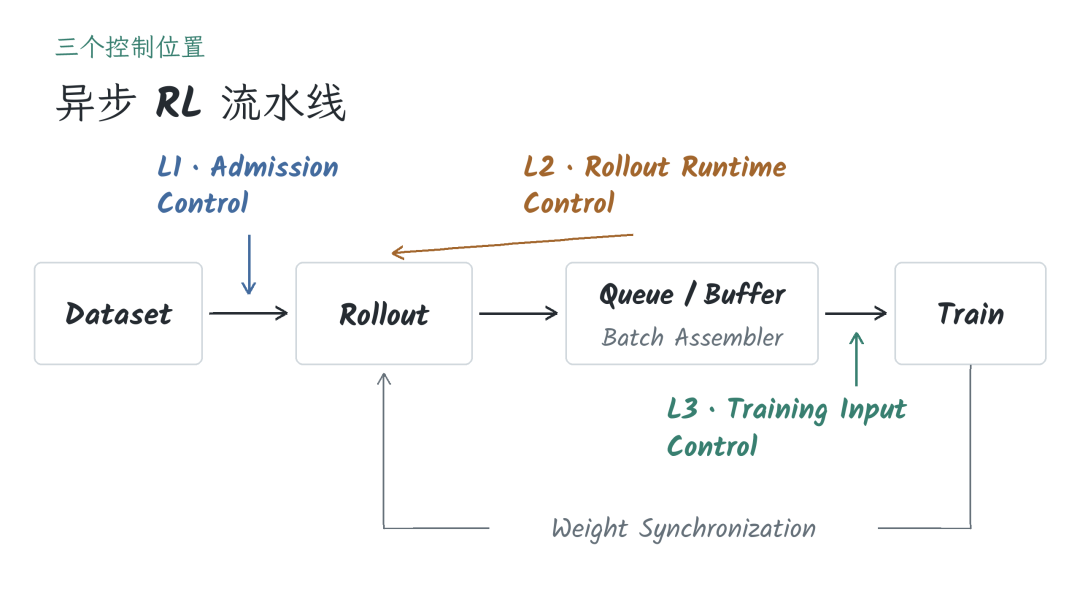
图 2:L1 准入、L2 运行时控制与 L3 训练前处理
L1:准入控制(Admission Control)
prompt 还没开始生成时,系统要先决定是否准入。通过准入控制来实现 staleness 控制的想法很直观:准入量越大,同一时期就越可能出现更多低版本的 trajectory,它们参与训练时的 staleness 也可能越大。因此,有的框架会限制生成中的 trajectory 条数,有的还会把已经生成完成、尚未被训练取样的结果一起计数。达到上限后,就先暂停准入。准入何时恢复则取决于具体机制,例如生成完成、结果被训练侧取走,或训练版本推进后释放新的额度。
这一层最为直接且成本最低,因为被拦住的 prompt 还没有消耗生成计算。但问题也最为明显:只限制数量,并不意味着能够限制每条 trajectory 的 staleness。 假设系统最多允许 8条 trajectory 同时生成,其中一条从 v0 开始后一直没有完成。与此同时,其余槽位不断生成较短的 trajectory,使训练侧能够持续组 batch 并将模型更新到 v5。此时,长 trajectory 仍只占用一个槽位,没有违反准入上限,但若这条 trajectory 最终生成完成并参与 v5 的训练,其中由 v0 生成的 token 的 staleness 就会高达 5。
因此,L1 层面的控制可以减少数据积压,但仅靠数量限制,无法保证每条 trajectory 的 staleness 都不超过阈值。
L2:Rollout 运行时控制(Rollout Runtime Control)
准入后,trajectory 就开始生成了。系统可以在权重更新或同步等特定时机检查仍在生成的 trajectory,并取消那些已经不可能满足 staleness 上限的任务。具体检查时机、比较的版本以及取消条件取决于框架实现。
例如,一条 trajectory 从 v1 开始生成,到 v5 仍未结束。若允许的最大 staleness 为 3,此时版本差已达 4,系统便可在本次版本推进时取消它,无需等其完整生成后再处理。取消越早,节省的后续计算越多。但无法避免的是,此前已生成的 token 会被浪费。
仅增加 L2 层面的控制仍不够:trajectory 生成完成后仍可能排队,而 L2 无法覆盖这段排队等待时间。trajectory 可能通过 L2 检验,却在后续排队过程中最终超过 staleness 上限。
L3:Training 前控制(Training Input Control)
生成完成后,trajectory 通常会在 queue/buffer 中等待训练侧取样。系统可以按 FIFO(先进先出)等策略选择结果,也可以在取样或组装 batch 时检查其版本信息。一方面,系统可以将超限的 trajectory 或 group 排除在训练 batch 之外。被排除后,框架可以重新取样以补齐 batch。另一方面,系统也可以选择停等,确保某一个较旧版本的数据全部完成,防止超限。
L3 最接近训练入口,也是实现严格 staleness 控制最直接的位置。到了这里,系统可按实际训练版本检查 trajectory,只让合格结果进入 batch,也可以暂停训练,等待指定的数据就绪。但是,在 L3 进行控制的代价也很明显:若此时选择丢弃,整条 trajectory 的生成计算便白费了。若选择等待,训练端就可能因少数长尾而停下来,即使其他结果已经生成完成,也未必能立即用来补位。
因此,L1 能否限制过量准入、L2 能否提前终止超限生成,都会在一定程度上影响 L3:若 L1 准入控制得当,且 L2 能及时取消在途生成,则在 L3 开始训练前,更多数据可及时完成并满足 staleness 限制,从而减少 L3 因丢弃或停等产生的开销。
接下来,我们把 L1–L3 的分层逻辑对照到主流异步 RL 框架中,看看不同机制能提供什么样的保证。
下图汇总了 10 个框架、14 种配置的做法:“控制位置”列出机制介入的环节,“概述”则用一句话说明它如何工作。最后一列则回答我们最终关心的问题:能否保证所有训练 token 都不超限?
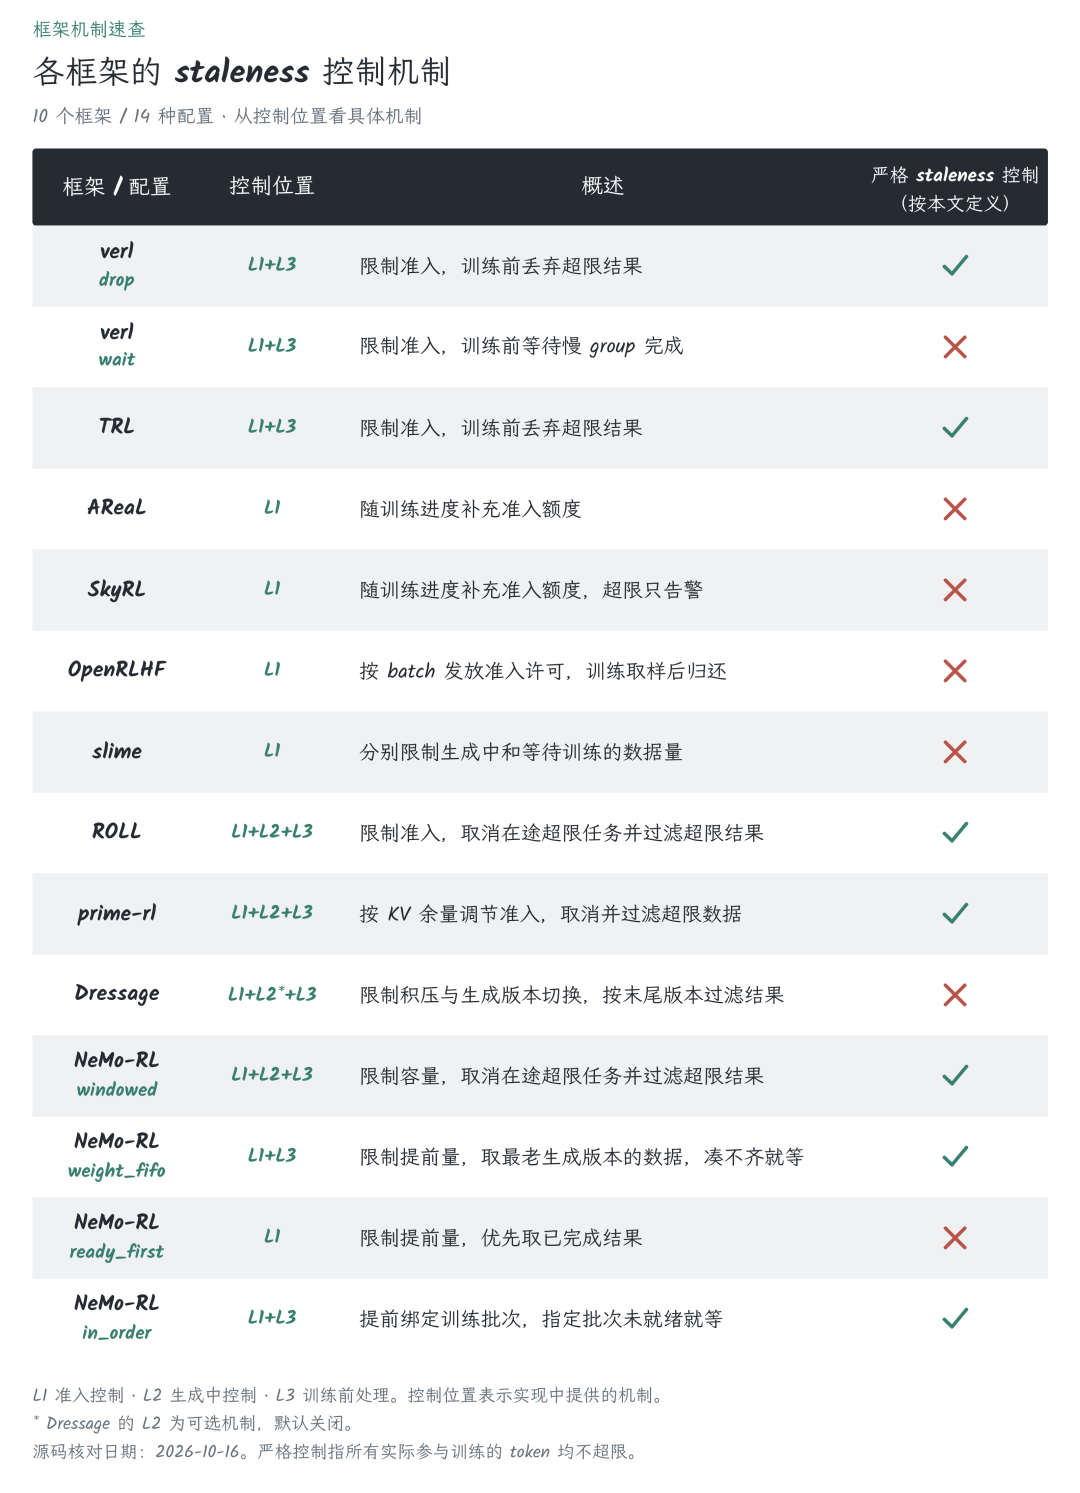
图3:10 个框架、14 种配置的控制机制与严格 staleness 控制
我们在[各框架 staleness 控制机制的详细分析] (https://lhy101.github.io/blog/async-rl-staleness-1)中逐一梳理了这些框架的设计与实现,并分析其是否真的具有严格控制 staleness 的能力。在[控制机制的实验验证与对比](https://lhy101.github.io/blog/async-rl-staleness-2)中,我们进一步验证了它们的实际表现,并讨论了准入量、超限丢弃等因素和有效吞吐之间的关系。感兴趣的读者可以阅读这些补充材料,本文不再一一展开。
把这 10个框架的 14 种配置放在一起看,staleness 控制大致可以分成两类。其中第一类仅在 L1 限制准入量,AReaL、SkyRL、OpenRLHF 和 slime 都属于这一类,NeMo-RL 的 `ready_first` 配置也是如此。它们通过限制准入额度、并发或待处理工作量,减少系统里的积压。这类做法比较简单,不需要为了限制 staleness 而丢弃数据,但局限也很明显:一个慢 prompt 对应的 trajectory 仍可能跨过许多训练版本,单靠总体数量限制,无法保证个体 trajectory 参与训练时的 staleness 上限。
以 AReaL 为例,其通过一个核心参数 `max_head_offpolicyness` 来限制准入额度。设 `max_head_offpolicyness` 为 h,当前训练版本号为 v,每个 batch 包含 B个 prompt,则其累计准入上限为:
这一上限限制的是累计已完成的 prompt 数,加上当前生成中的 prompt 数。例如,B=16、h=1 时,初始版本 v_0 最多准入 32个 prompt。训练推进到 v1 后,上限进一步增至 48,又能准入 16 个。也就是说,训练每更新一个版本,就解锁一个 batch 的新准入额度。但只要其他数据能推动训练继续,一个慢 prompt 就可能跨过多个训练版本,却始终只占一个额度。因此,准入上限并不等于每条 trajectory 的 staleness 上限。
我们可以通过下面的一组模拟实验来验证我们的分析:
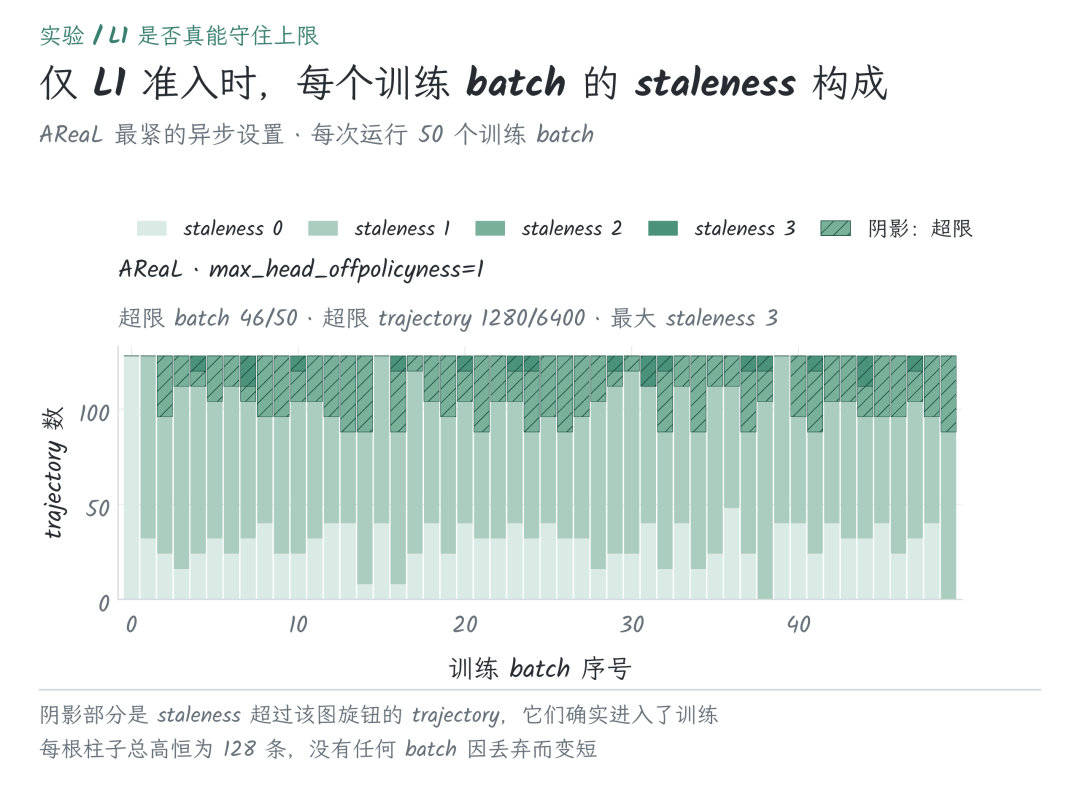
图4:AReaL 参数设为 1 时,逐 batch 的 staleness 构成
在这组实验中,我们观察在 AReaL 的 staleness 控制机制下每个 batch 的实际数据构成。可以发现,虽然 `max_head_offpolicyness=1`,实际最大 staleness 却达到了3,50 个训练 batch 中有 46个包含超过该参数值的 trajectory。图中每根柱子对应一个 batch,斜线阴影标出超过参数值的部分。这些数据实际参与了训练,说明仅仅限制 L1 准入提前量并不能直接保证每条数据的 staleness 上限。
4. 第二类:能够控制住 Staleness 但存在明显代价
另一类方法包括 verl、TRL、ROLL、prime-rl、Dressage,以及 NeMo-RL 的其他三种配置。与仅依赖 L1 准入控制的方案相比,这类方法的核心区别在于在训练前增加了 L3 丢弃或等待机制,部分方法还会进一步通过 L2 提前终止生成。得益于这些机制,这一类方法几乎都能够实现严格的 staleness 控制。(PS:个别方法仍无法提供严格保证,详见[各框架 staleness 控制机制的详细分析] (https://lhy101.github.io/blog/async-rl-staleness-1)。)
其中,相当一部分方法选择在 L3 丢弃超出 staleness 阈值的生成结果。这是因为 L3 最接近训练入口,按训练版本检查并排除超限结果,是实现严格 staleness 控制最直接的办法。 然而,这种方式虽然能够简单有效地限制 staleness,却也带来了明显的计算浪费:当数据到达训练入口时才发现其已经超限,此前的生成、后处理乃至 reward 计算都已经完成,相关计算资源也就白白消耗了。
此外,我们在[控制机制的实验验证与对比](https://lhy101.github.io/blog/async-rl-staleness-2) 中还观察到,这种 L3 丢弃不光会降低有效吞吐,还会使保留的数据偏向更短的序列。也就是说,L3 丢弃不仅浪费了计算,还会使得数据构成变得有偏。感兴趣的读者可以阅读补充材料。
而与常见的 L3 丢弃策略不同,NeMo-RL 的 `weight_fifo` 和 `in_order` 采用了另一种思路:预先规定好训练 batch 组成,当指定 batch 的数据尚未就绪时,就让训练等待,从而无须依赖丢弃超限数据来保证 staleness 上限。具体来说,以 `in_order` 为例,它在准入阶段就将每批数据绑定到一个固定的训练版本。假设 staleness 上限设置为 2,那么当训练处于 v0 时,NeMo-RL 会提前准入三批 prompt,分别绑定到 v0、v1 和 v2 三个训练版本。当训练推进到 v1 时,如果分配给该版本的 batch 尚未全部完成,即使绑定到 v2 的 batch 已经就绪,训练也必须继续等待,而不能直接使用后者补位。这种方式通过固定数据与训练版本的对应关系,避免了数据被推迟到更晚的训练版本使用,但也牺牲了调度的灵活性。系统可能因为某一个 batch 的长尾生成而不得不停等,从而使得最终吞吐受损。
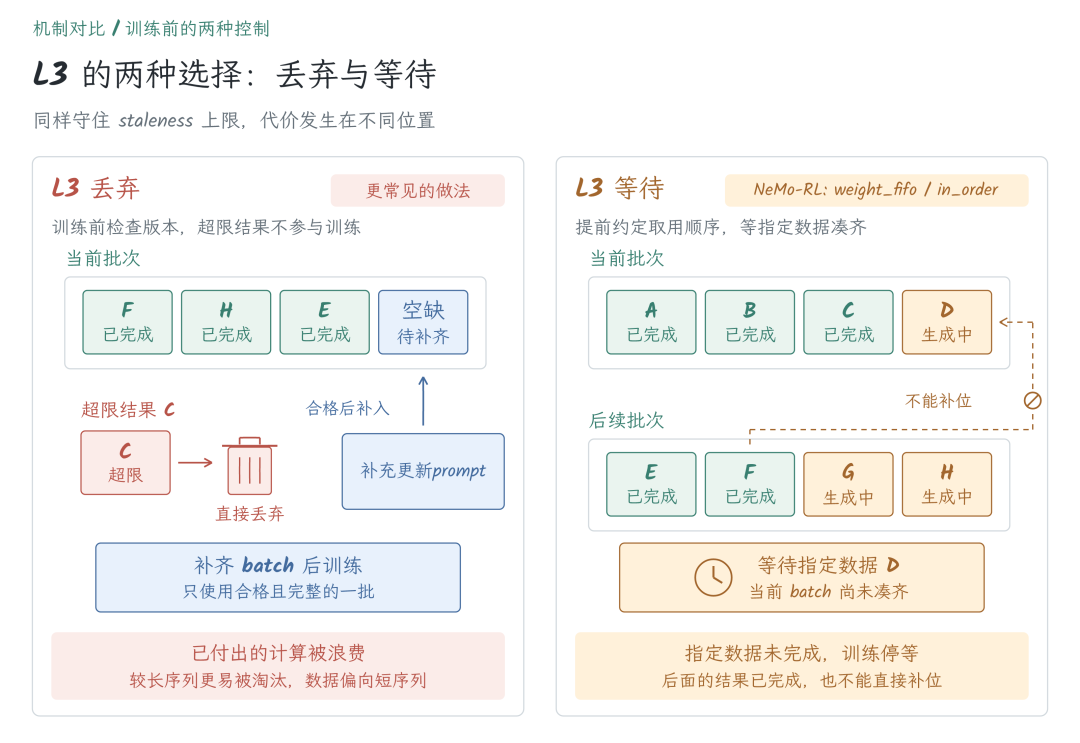
图5:L3 的两种策略:丢弃与等待,以及各自的代价
那么,一个很自然的问题就是:我们能否设计一套更灵活的 staleness 控制机制,在严格保证 staleness 上限的前提下,既不丢弃数据,又能减少停等?
我们顺着 NeMo-RL `in_order` 的思路想,提前规划训练位置确实可以在不丢弃数据的情况下严格控制 staleness。但问题是,我们是否一定要在准入时就将最终的训练 batch 完全固定下来? 我们能不能先为 trajectory 留好一个位置,等它真正完成时,再根据当时的数据就绪情况灵活调整 batch 组成?这样,较早完成的 trajectory 就有机会提前参与训练,而较慢的 trajectory 也不至于因为一直被往后挤而面临超限的风险。
基于这一思路,我们提出了一套 Reserve–Occupy 协议,其核心想法是把生成前的 L1 准入和训练前的 L3 batch 组装放在一起考虑,让两者在同一个协议下配合起来:在准入阶段我们就为 trajectory 规划后续的训练位置,而在 trajectory 完成后我们再根据实际情况动态调整 batch 组成,并将调整结果反馈给后续准入决策。通过这种方式,我们既能在不丢弃数据的情况下严格控制最大 staleness,又避免了过早固定训练 batch 所带来的调度灵活性损失。
下面,我们一步步讲解这套 staleness 控制协议。
1. 先给 trajectory 和 buffer 标上版本
异步训练里,一条数据生成出来时用的模型,和它后来参加训练时的模型,可能已经不是同一个版本了。要控制两者相差多远,首先得知道这条数据是用哪个版本生成的。
我们给每条 trajectory 记录一个 v_traj,表示生成它所用的权重版本。例如,用 v0 生成的数据就记为v_traj=0。这一节先考虑一条 trajectory 从头到尾使用同一版模型的情况,涉及多个版本的 partial rollout 放到后面的扩展里讨论。
接下来再看训练侧。训练端每次取一个 batch 更新模型,我们就在 rollout 输出和训练端之间引入一层 staleness buffer,用它来安排每条数据进入哪一轮训练。这一层与别的框架中 L3 前的 queue/buffer 的设计类似,但不同的是,我们的 staleness buffer 会提前规划好训练版本:我们会预设一些 staleness buffer,每个 staleness buffer 对应一个训练 batch,大小就是 batch size。 比如 batch size 为 4,每个 buffer 就有 4 个槽位,每个槽位容纳一条 trajectory。等 4 条数据都准备好了,这一批才可以交给训练端去训练。
在这套设计下,每个 buffer 会被分配一个独一无二的版本号 v_buffer,表示这一批数据将用于哪个模型版本的训练,例如:
- Buffer v0 用于模型从 v0 更新到 v1 的训练。
- Buffer v1 用于模型从 v1 更新到 v2 的训练。
- Buffer v2 用于模型从 v2 更新到 v3 的训练。
注意,Buffer v1 里存放的数据不一定由版本 v1生成:它只说明这些数据将一起参加 v1 -> v2 这轮更新。如果把一条v0 生成的数据(即 v_traj=0)放进 Buffer v1,它参加训练时的 staleness 就是 1-0=1。放进 Buffer v2,staleness 就成了 2-0=2。
这样,staleness 控制就被转化成了一个放置问题。设最大允许 staleness 为 η,要控制住 staleness,我们只要让每条 trajectory 最终落入的 buffer 满足:
这个不等式给出了数据最晚能放置的那个 buffer。例如 v_traj=0、η=1,这条数据可以进入 Buffer v0 或 Buffer v1,却不能再被安排到 Buffer v2。Buffer v2 即使完全空着,对它来说也已经太晚了。
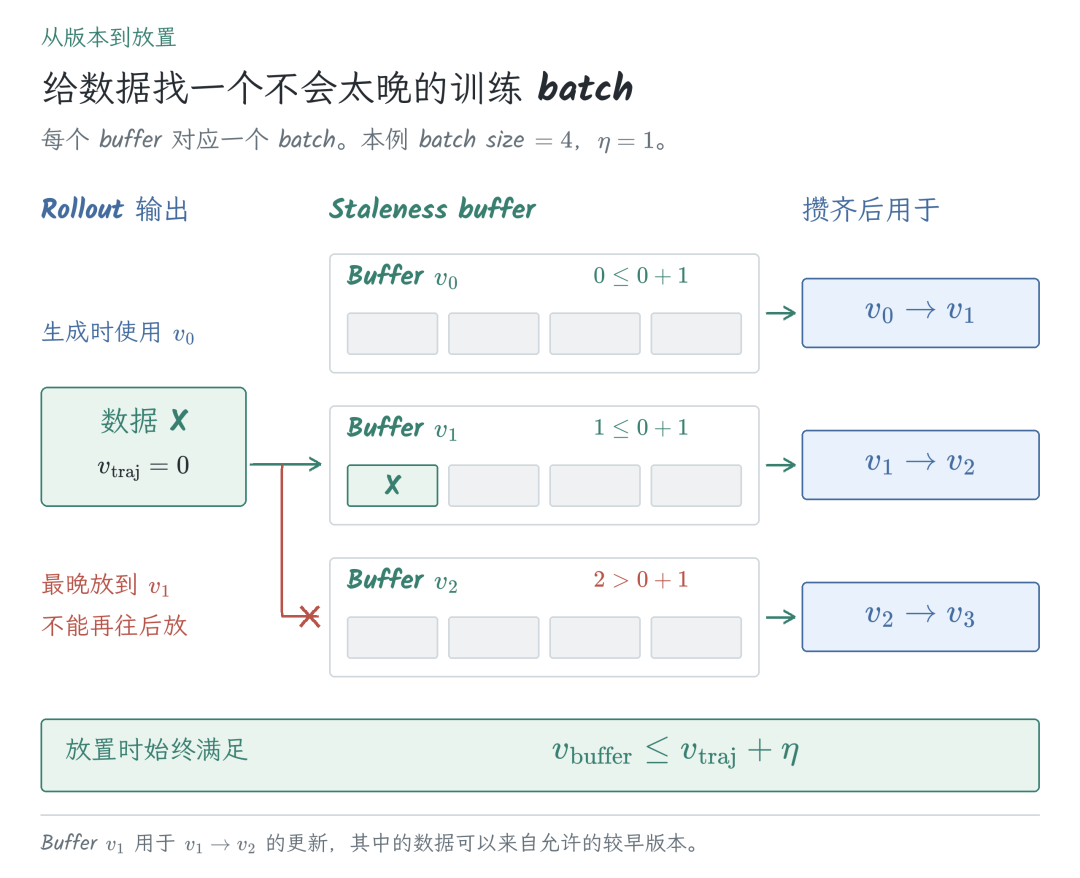
图里的数据 X 来自 v0,放进 Buffer v1 时满足 1≤0+1。如果继续往后放进 Buffer v2,就会违反 staleness 上限。
值得一提的是,这里的 buffer 只记录 trajectory 的元数据(包括 trajectory ID、版本等)。可以把不同 buffer 看成 trajectory 与训练之间的一张排布表,因此调整 trajectory 的位置不需要复制或移动实际的 trajectory 数据。
那么,具体该怎么去放置呢?最直接的想法,就是等一条数据完成了再给它找合法的位置。但问题也在这里:假设有一条长尾的 trajectory,等它慢慢生成完,前面允许它放置的 buffer 可能已经满了,甚至可能都已经被拿去训练了。这时再找位置,就只能放在一个靠后的 buffer 中,不满足v_buffer ≤ v_traj+η 的约束,从而超出 staleness 上限。
所以,安排放置的时机不能拖到最后,我们必须“未雨绸缪”:(1)在开始生成前,我们就需要提前预留一个合法位置,确保生成完成后仍有地方放而不会让 staleness 超限。(2)真正生成完成时,再决定最终放在哪里(最差也可以放在之前预留的位置上)。在这样“两步走”的放置设计中,我们把前一步称作 Reserve,后一步称作 Occupy。
这也意味着,buffer 里会同时出现尚未完成和已经完成的 trajectory。为了区分它们,我们让每个槽位有 3 种状态:
- Empty:还没有安排任何 trajectory 的空槽。
- Reserved:已经为一条 trajectory 预留位置,但结果还没完成。
- Occupied:trajectory 已经完成,实际放进了这个槽位。
有了这 3 种状态,L1 准入检查就很好理解了:看看现在还能不能为这条 trajectory 做一次 Reserve。 我们扫描尚未取用、满足 v_buffer ≤ v_traj+η 的 buffer,检查其中是否还有 Empty 槽位。有的话,就先把这个空槽变成这条 trajectory 的 Reserved,再开始生成。没有的话,就无法保证新准入的 trajectory 生成完毕后还有合法位置放置,因此必须暂缓准入。
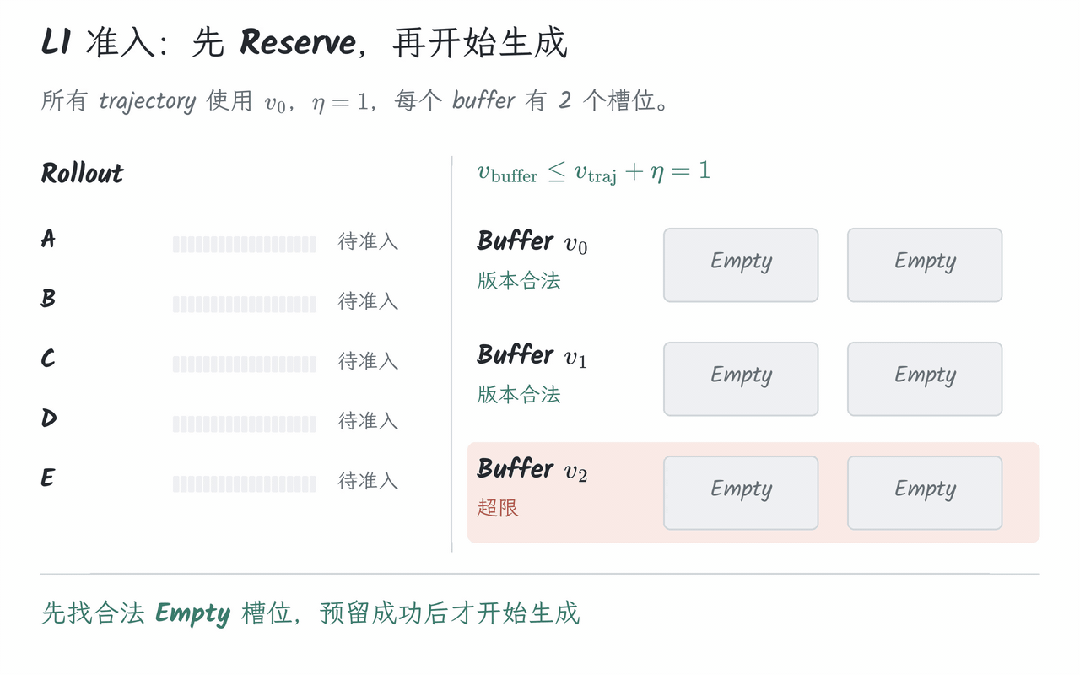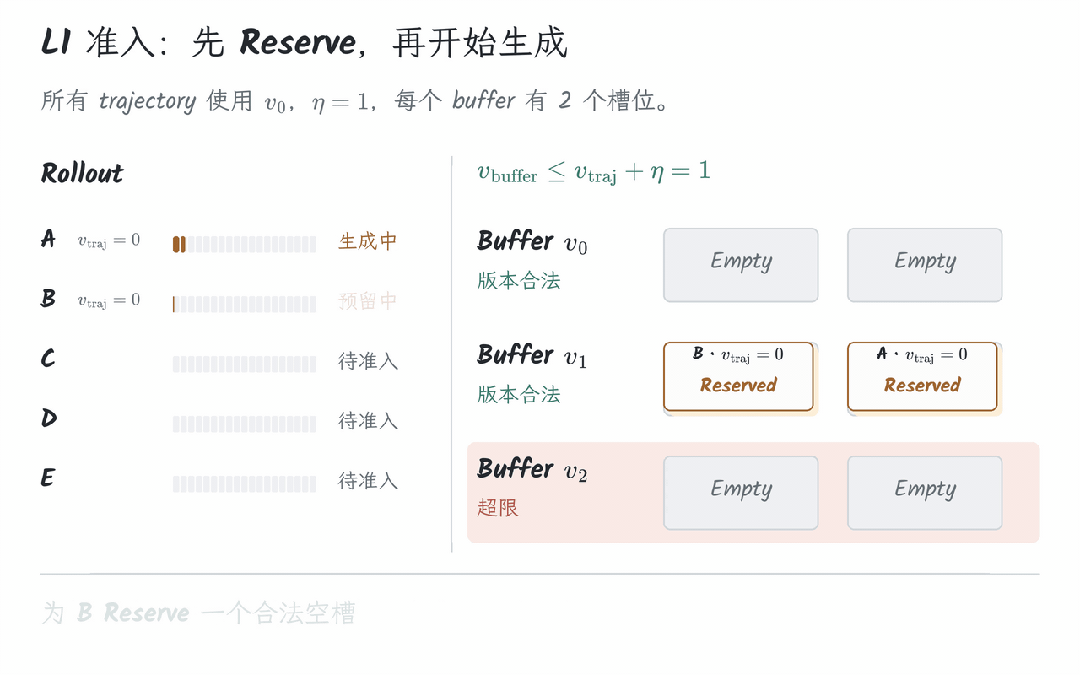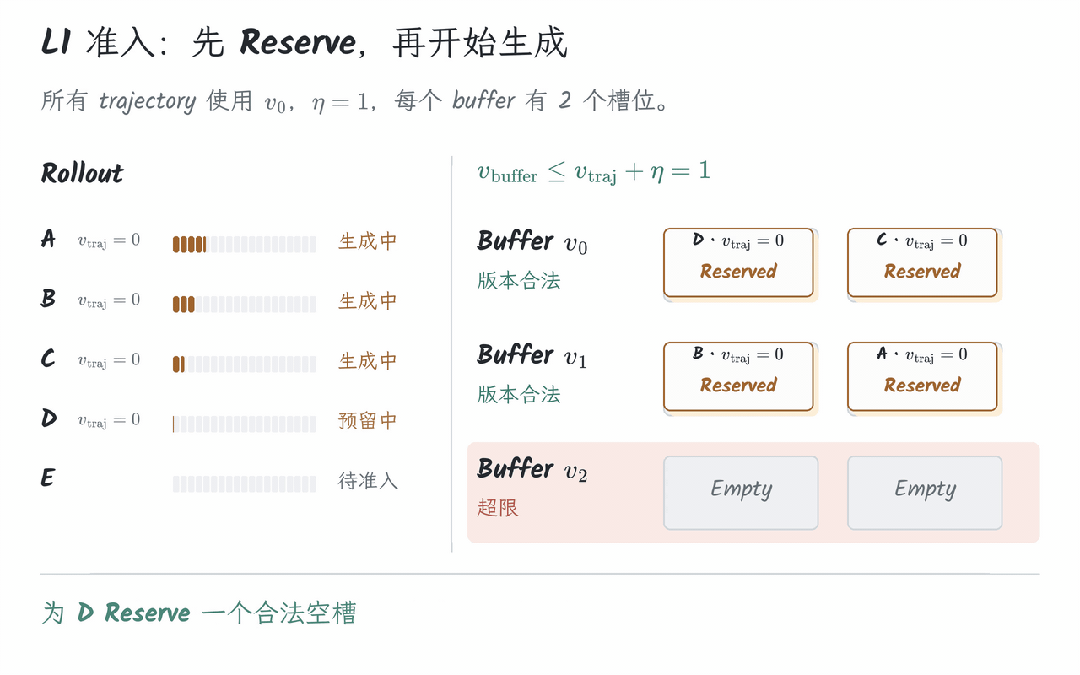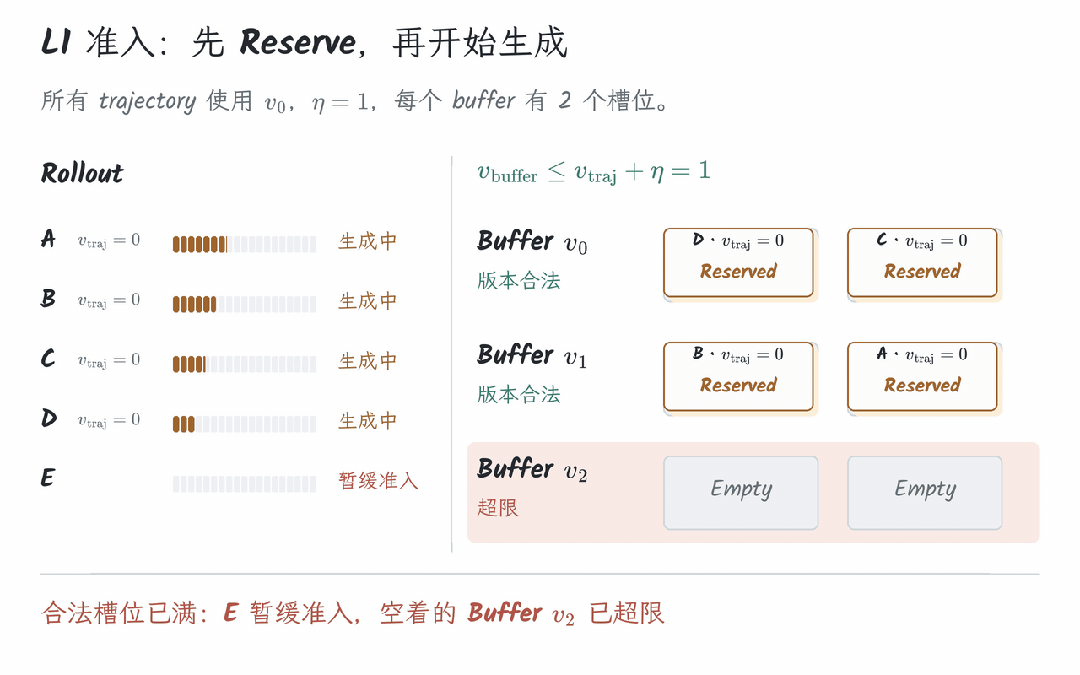
图7:为新准入的 trajectory 预留合法槽位
Reserved 虽然还没有实际数据,但也不能再算成空槽,因为它已经为一条在途 trajectory 留好了位置。多个 trajectory 同时准入时,也必须以成功预留为准,不能因为各自都看到过空位,就一起开始生成。这样,每条成功准入的 trajectory 才确实有一个合法位置可去。
3. 按最差情况 Reserve,按最好情况 Occupy
那么,具体应该Reserve和Occupy到哪个槽位呢?
开始生成时,我们还不知道谁会先完成。既然如此,不妨先按最差情况来安排,优先在合法范围内较晚的 buffer 中 Reserve,并优先使用其中靠后的空槽。 即使这条 trajectory 很慢,它也已经有了一个不超过上限的最差位置。同时,前面的空槽可以尽量留给较早完成的数据,帮助更早的 batch 攒齐。
等 trajectory 完成,最稳妥的做法当然是就在自己之前预留的位置原地 Occupy。因为这个位置此前已经通过检查,直接把 Reserved 变成 Occupied 就可以保证不超限。不过如果始终这样做,生成前安排在哪个 buffer,最终就留在哪个 buffer,整体效果也就退回到了类似 NeMo-RL `in_order` 的固定批次安排上了。
来看一个小例子。每个 buffer 有 4 个槽位,A–F 都由 v0 生成,η =1,初始从后到前依次 Reserve。假设 B 最先完成,它原本预留在 Buffer v1 的第 3 个槽位。按原地 Occupy 的做法,我们只需把这个槽位从 Reserved 变为 Occupied 就可以了,其他位置完全不用动。
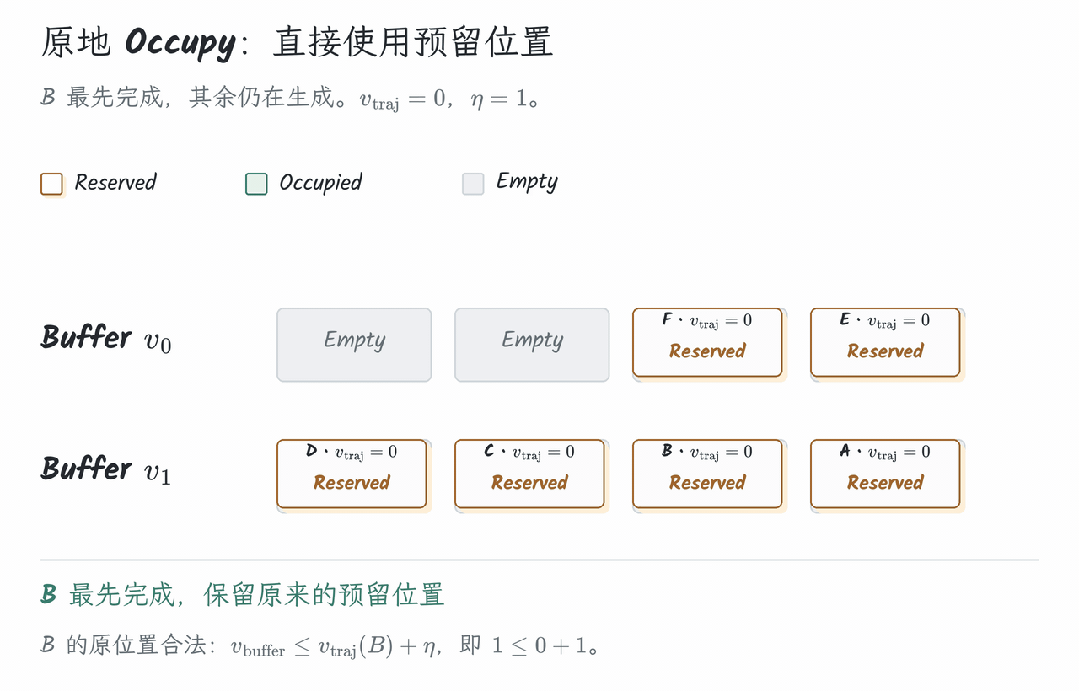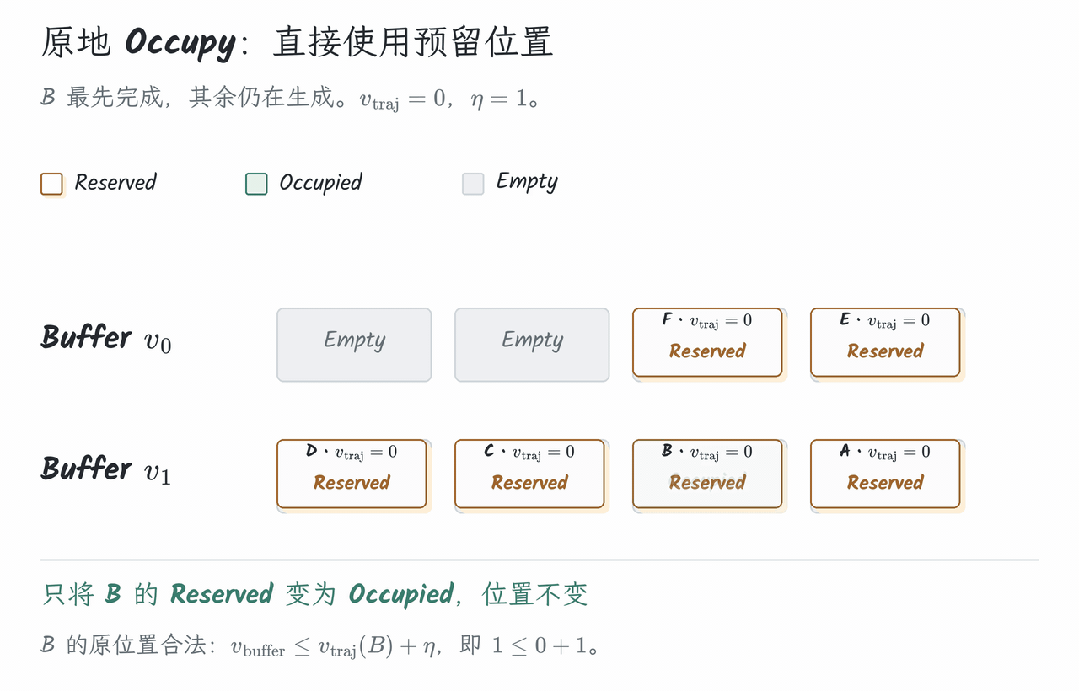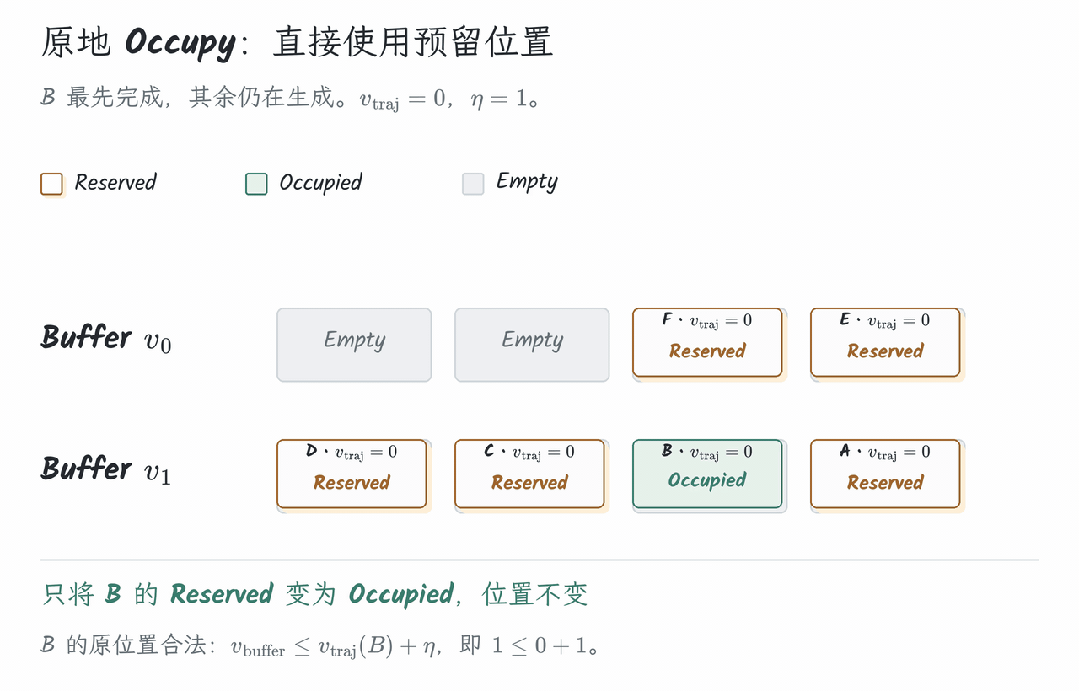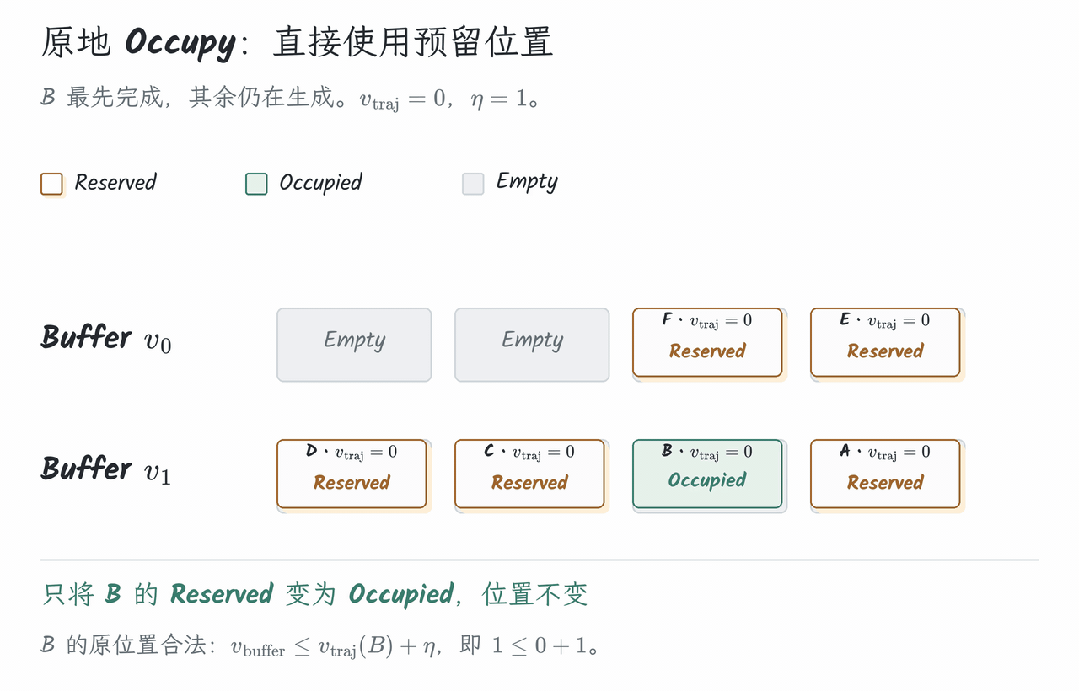
这样的做法当然满足 staleness 约束,但也有些可惜:B 明明已经完成,前面的 Buffer v0 也有空槽,它却只能留在后面的 Buffer v1,等到下一轮才参与训练。
所有,真的必须 Occupy 在原先 Reserve 的位置吗?其实不必。Reserve 只提供“最差也有合法位置”的保证,而不是替 Occupy 决定最终的放置位置。事实上,只要最终的放置位置依然满足
就可以把已经完成的数据放得更早。
具体来说,我们可以释放原先的预留槽位,整理可移动的 Reserved,再寻找当前最早的合法 Empty 槽位,将结果放进去。
这里为什么还要整理其他 Reserved?因为刚释放的空位可能在后面的 buffer,而前面还留着一些正在生成的 trajectory 的预留。既然这些数据还没完成,只要版本允许,就可以把它们的预留后移,用上刚腾出来的空位,继续把靠前的空间留给已完成的数据。
这么说有点抽象,让我们回到刚才那个例子,B 预留在 Buffer v1 的第 3 个槽位并率先完成。这一次,我们这样处理:
1. 删除 B 的 Reserved,把已经完成的 B 暂存。
2. 从前往后扫描 Reserved,找到第一个能合法移入这个空位的 F。把 F 的预留移到 B 刚刚释放的 Buffer v1 第 3个槽位。
3. 为 B 寻找最早的合法 Empty 槽位。Buffer v0 第 1 个槽位就是最早的空槽位,因此 B 直接落在那里。
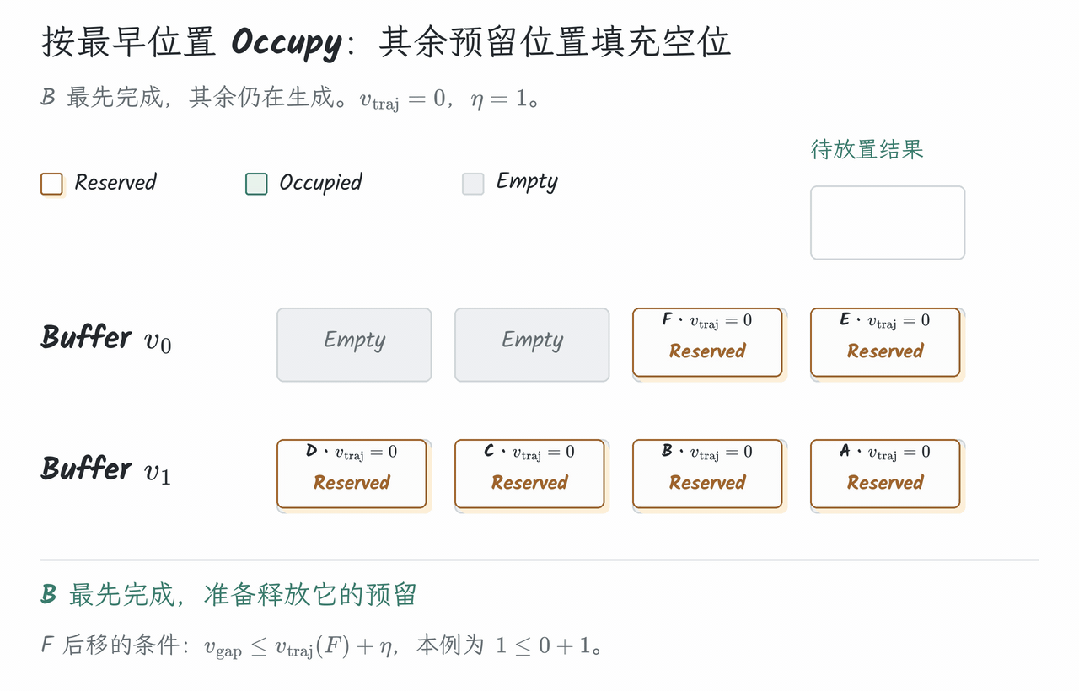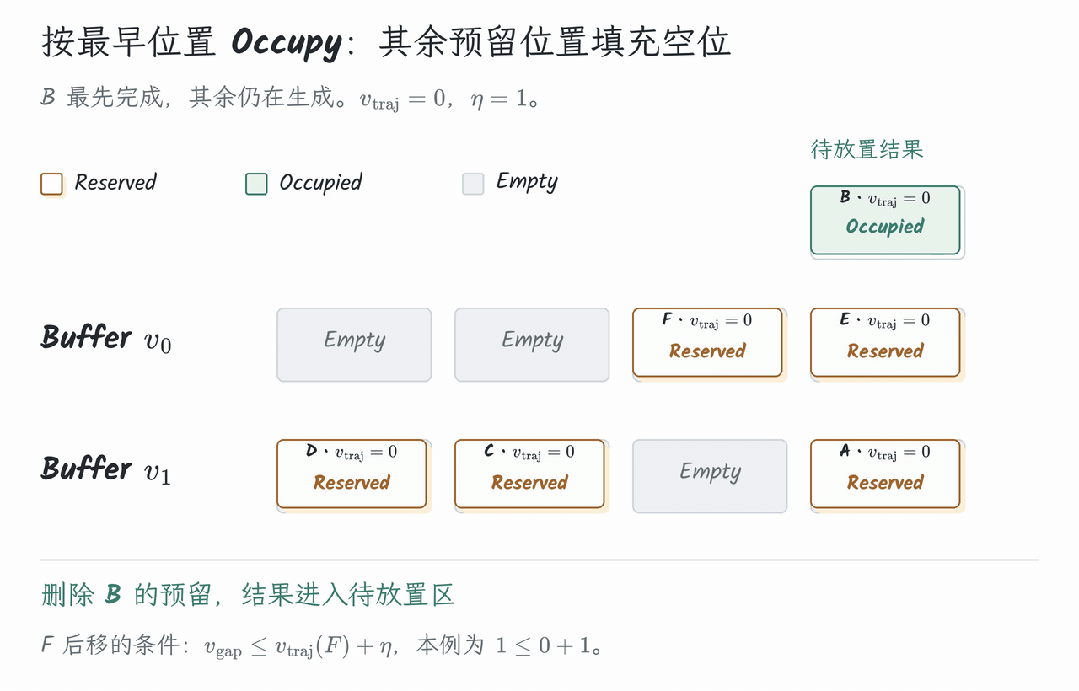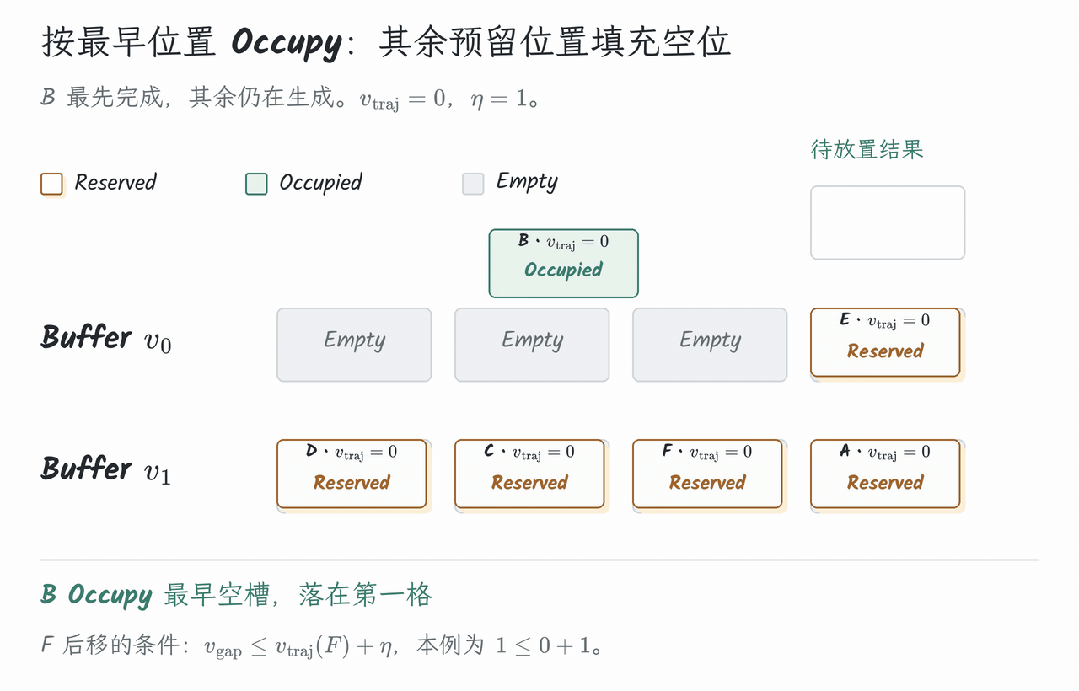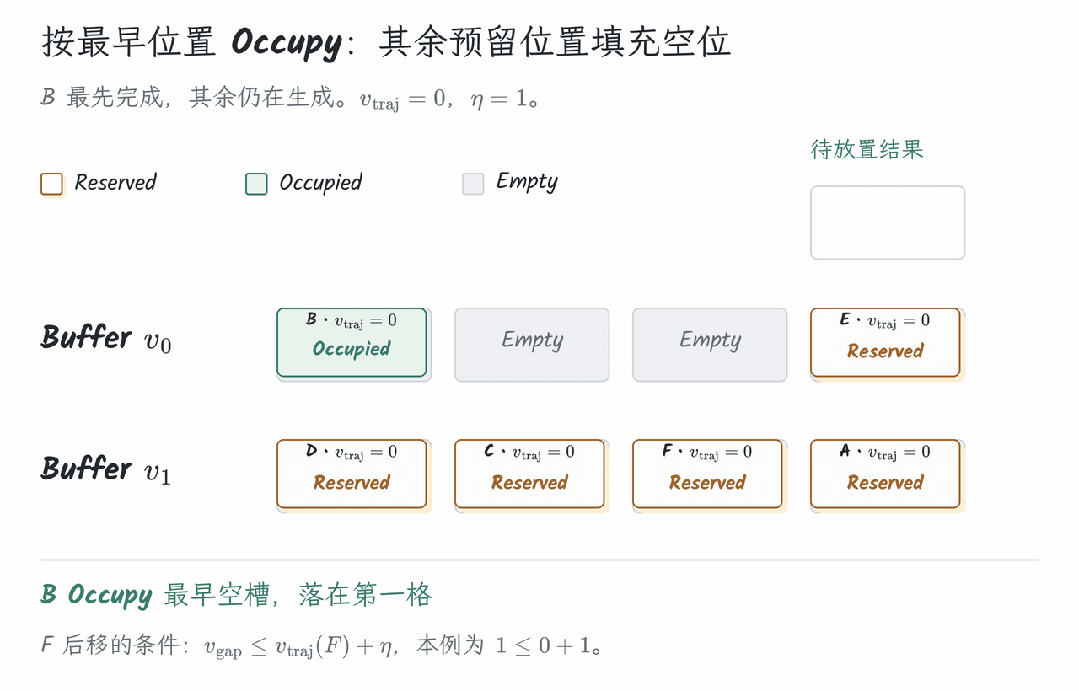
图9:整理预留,让已完成的 trajectory 尽早放置
和之前原地 Occupy 的流程相比,B 从后面的 buffer 提前到了前面的 buffer,F 则接替了 B 原先的预留位置。
这样调整是安全的,因为 F 和 B 各自的预留和占用均满足 staleness 约束:B 已经完成,可以直接填进更早的 buffer,而 F 虽然还在生成,但后移之后依然保有合法预留,仍满足 staleness 约束,并没有因为给 B 让出空间而失去位置。
这样调整的目的,是让已经完成的数据尽早参与训练,同时让尚未完成的 trajectory 的预留尽量靠后。 本例中,Buffer v0 第 1 个槽位是空的,B 可以直接占用,帮助训练侧攒齐 batch。而后移 F 的作用,是把它占着的第 3 个槽位也腾出来,给后续完成的数据留下更多靠前的空间。
当然,不是每个 Reserved 都可以随意后移。F 能不能填进这个空位,要看 F 自己的版本和目标 buffer 的版本。把目标空槽所属 buffer 的版本记作 v_gap,搬移必须满足
本例中就是 1≤0+1,所以 F 可以移动。扫描时,我们选择前面符合条件的最早 Reserved 即可。
这就是我们协议“按最差情况 Reserve,按最好情况 Occupy”的最终形态了:生成前先留好合法位置,完成后再根据当前排布尽量往前放。 如果没有更早的空槽,最差也可以使用本次操作前仍有效的预留位置。这样,我们既保住了每条 trajectory 的 staleness 上限,又为前面的 batch 提前攒齐创造了条件。
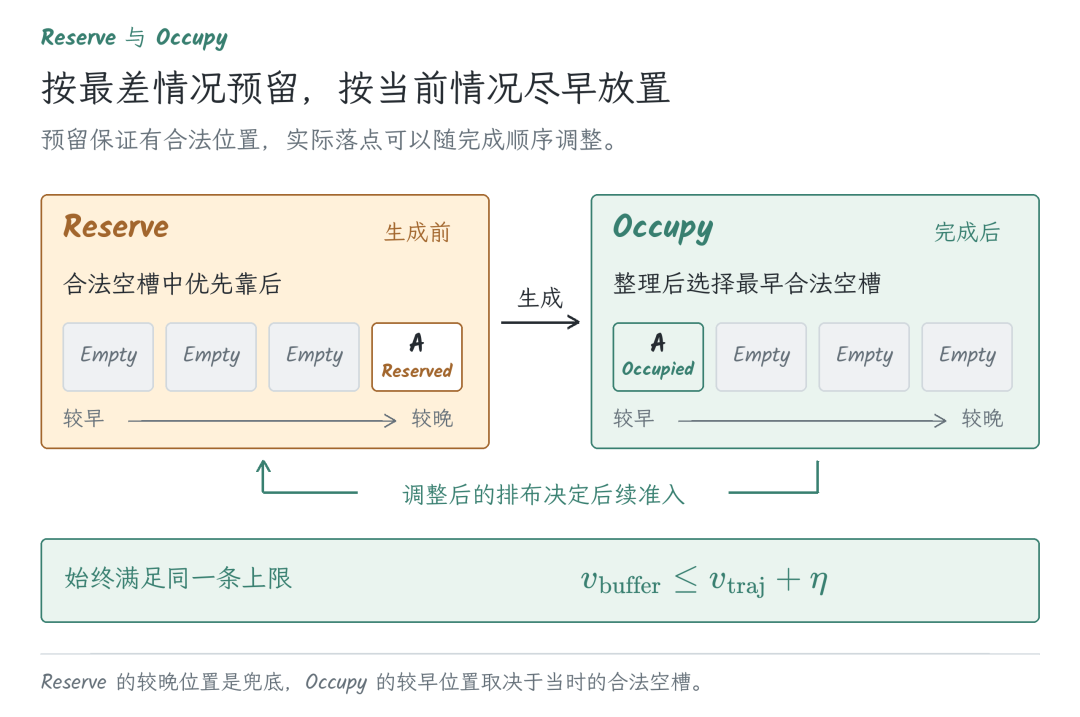
图 10:按最差情况 Reserve,按最好情况 Occupy
按照这样的协议操作,最终每个 buffer 中一定是 Occupied 集中在前面,Reserved 留在后面,中间是 Empty。因此,实际的 buffer 只会出现下面3 种状态:
- PENDING:仍有空槽。
- STUCK:空槽已经用完,且其中存在 Reserved 槽位,要等新的 trajectory 完成。
- READY:整个 buffer 都是 Occupied,数据已凑齐。
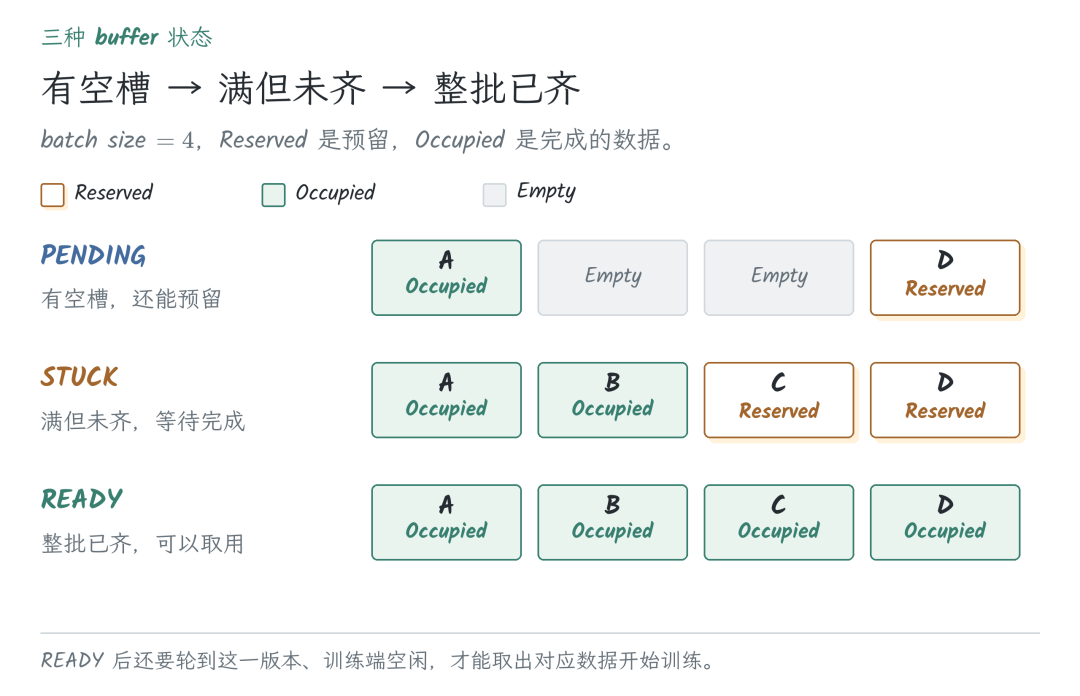
图 11:PENDING、STUCK 与 READY 三种状态
如果当前版本的 buffer 已经 READY,而且训练端空闲,就可以取出 buffer 对应的数据开始训练。例如,取出 Buffer v0 的数据后,训练端开始 v0-> v1 的模型训练与更新。而只有更新完成并发布 v1 后,新的 trajectory 才能使用这版模型继续生成。在 η=1 时,这些新 trajectory 可以预留的位置也就随之扩展到了 Buffer v2,从而允许生成端继续推进。
最终的效果就是:buffer 攒齐决定训练何时能开始,训练完成产生的新版本则让后续 trajectory 获得更靠后的合法 buffer 槽位去 Reserve。 它们相互衔接,使得生成和训练在此期间持续重叠运行。
下面使用 η=1、batch size 为 4 的设置作为一个代表性的示例(η 表示 staleness 上限)。另外,我们为 rollout 侧设置 max concurrency 为 6,表示最多同时生成 6 条 trajectory。这是可调的运行参数:可以根据 rollout instance 数量、每个 instance 的并发能力,以及 KV cache 容量、序列长度等选择。它不改变前面的 staleness 控制协议。
max concurrency ≤(η+1)×batch size时该参数才有意义。此例中对应 6≤8。6个并发名额限制“同时跑多少条”,8 个合法槽位则意味着全部 Reserved、Occupied 和 Empty 加起来不会超过 8。在这里,每个预留对应一条正在生成的 trajectory,所以 Reserved 数就是正在生成的数量。如果所有合法槽位都满了,即使生成并发数尚未达到上限,也要停止准入。
下面,我们来看一下完整的端到端演示,一共跑了 3 个批次的 RL 训练:
视频 1:Reserve–Occupy 协议的完整端到端演示
视频左侧每行是一条 trajectory,进度条总长度与这条 trajectory 从准入到完成的用时成比例。v_traj 为准入时赋予 trajectory 的版本编号。右侧则是 3 个用于训练的 staleness buffer 的变化情况。演示动画中的移动是为了把因果关系说明清楚,协议本身的 Reserve 和 Occupy 都是瞬间完成的。
感兴趣的读者如果希望了解每次准入、预留调整和训练推进的具体细节,欢迎扩展阅读[Reserve–Occupy 协议关键步骤分析](https://lhy101.github.io/blog/async-rl-staleness-3)。
上面的演示展示了最简单情形下的 staleness 控制协议。为了满足实际算法和系统优化的需求,我们还可以基于这套协议做出以下扩展(这些扩展功能均可以按需启用)。
(1)Partial Rollout
一条 trajectory 可以由多个版本逐步生成(即前文介绍的 partial rollout),而这些版本一定是单调递增的。因此,我们在准入时记录的 v_traj 就是整条 trajectory 使用的最早模型版本,而后续片段的版本只会逐步增大。比如最早的前缀来自 v0,尽管后续使用 v1、v2 依次生成,整条 trajectory 的标签依然会按 v0 计算。最终放置时仍按这个最早版本检查:
因此,partial rollout 完全不影响协议的 staleness 约束检查:partial rollout 改变了具体的生成过程,但不会改变准入时的 v_traj,也因此不会改变最终的放置判定。故而,对于 partial rollout,我们无需放宽版本上限或另设规则,仍可使用同一套约束检查。
(2)Reserved 槽位丢弃
尽管我们设计这套协议的初衷是在不丢弃任何数据的情况下保证 staleness,但对于耗时过长或检测出问题的 trajectory,我们也支持追踪 Reserved 槽位的状态,并主动丢弃对应的 trajectory。这样一方面可以进一步提高系统性能,另一方面也能让协议更加健壮,不会因为某个 trajectory 出现错误或卡死而导致整个协议瘫痪。
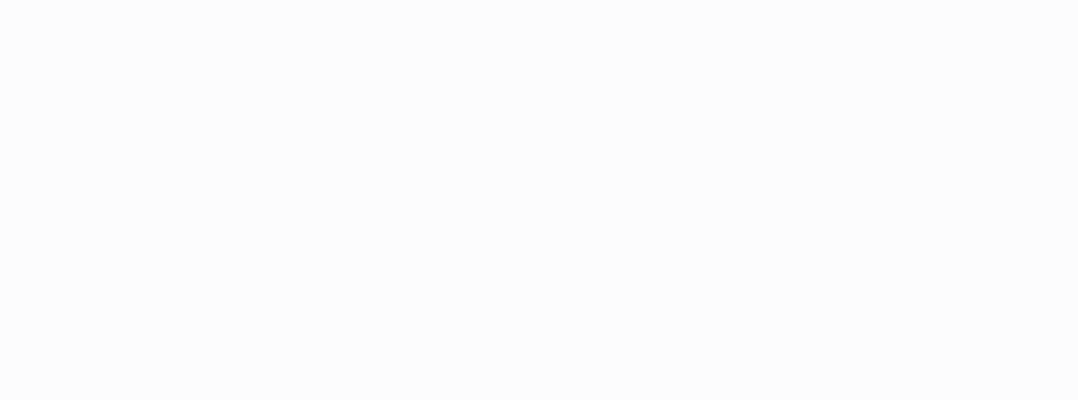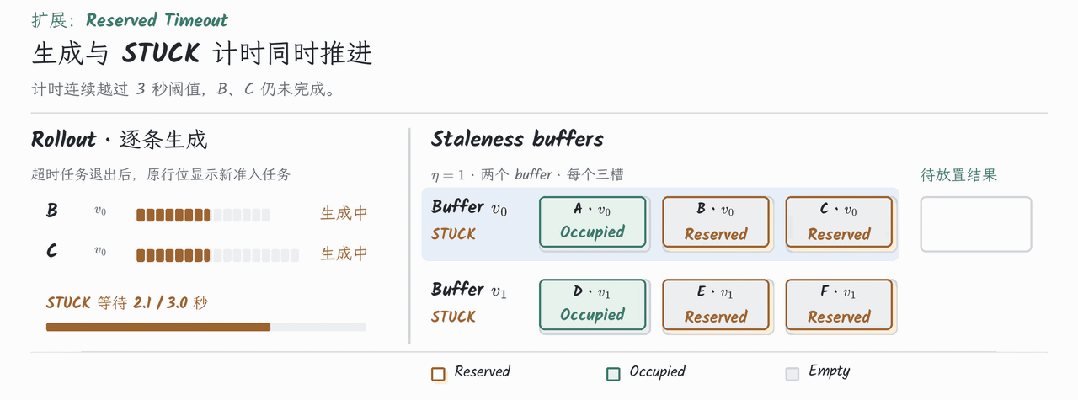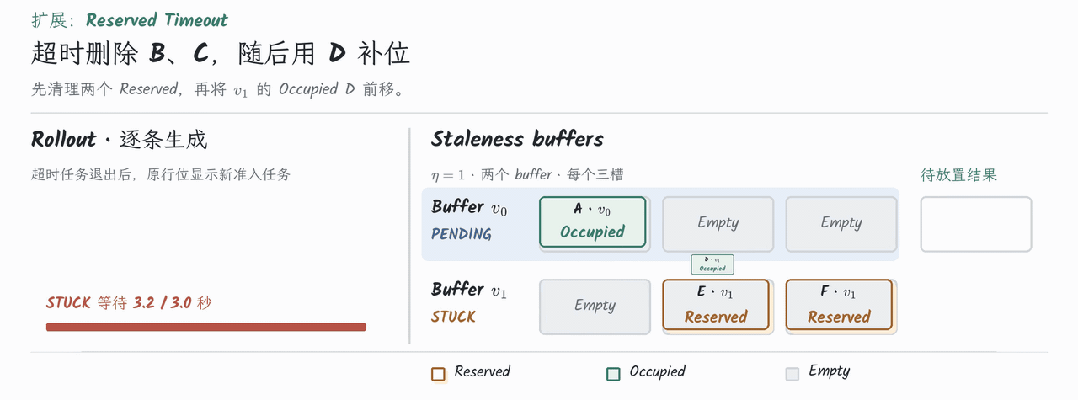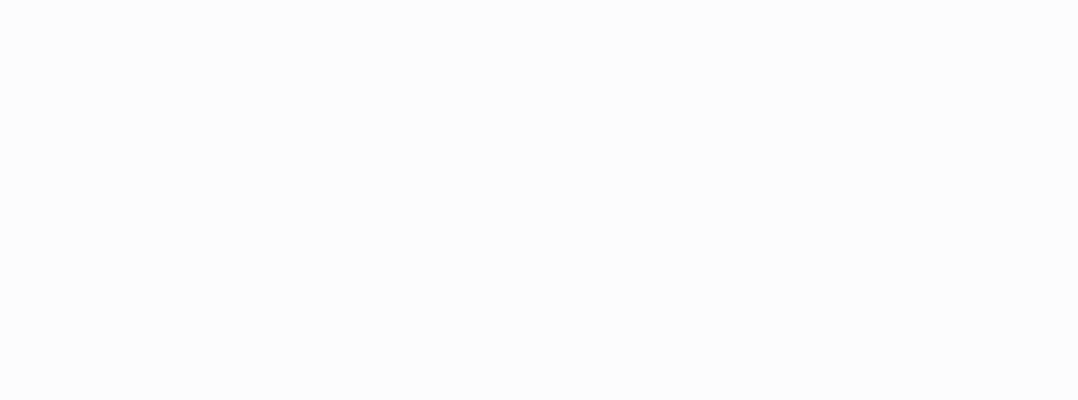
下面,我们用一个超时错误作为例子:当训练端开始等待 buffer 攒齐时,我们检查最近的 buffer,如果它处于 STUCK 状态,就可以开始计时。当等待时间超过阈值后,就清空该 buffer 中剩余的所有 Reserved 槽位。此时,如果后面的 buffer 中已经有 Occupied 的数据,可以直接将其前移,填补空位,尽快攒满 buffer。另一方面,由于空出了槽位,我们可以从数据集中准入新的数据进行生成,来弥补丢弃的数据。
(3)Occupied 槽位筛选
此外,过滤也可以发生在条目已经变成 Occupied 之后。例如,在后处理中,如果我们确认某条数据无效(不提供任何梯度,或数据本身存在问题、属于脏数据等),我们同样支持清空这个槽位,再从后方取出 Occupied 数据填入缺口,并继续准入新的数据。
下面的例子中,C 完成后先写入 Buffer v0,随后因为某些原因而被过滤。我们将 Buffer v1 中已处于 Occupied 状态的 D 前移补位,尚未完成的 E、F 仍保留为 Reserved。由于新的空槽位诞生,我们随后就可以准入新的数据 G 继续生成。
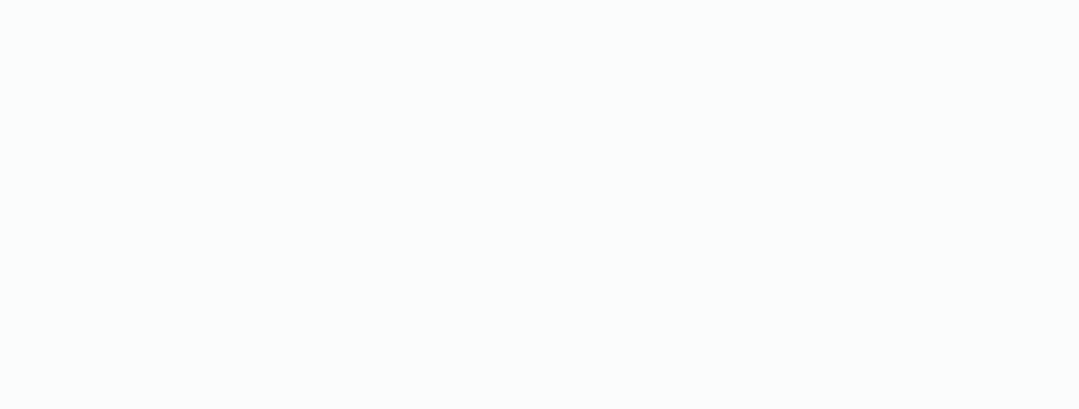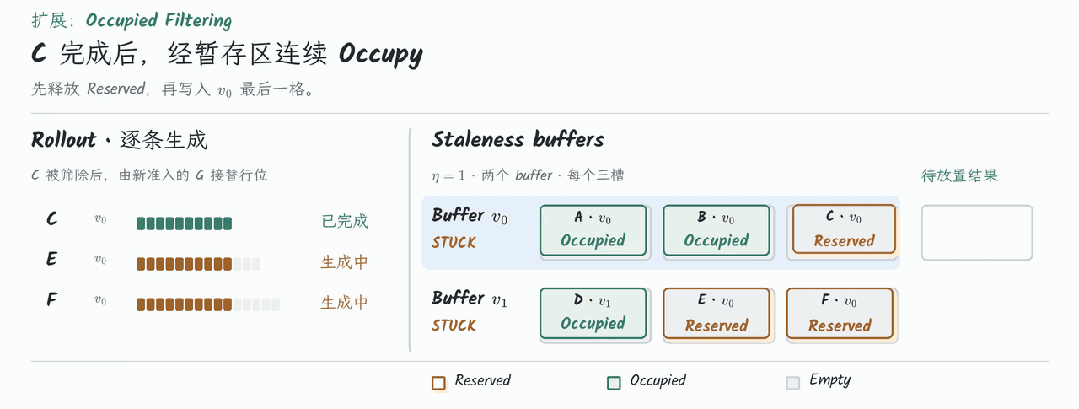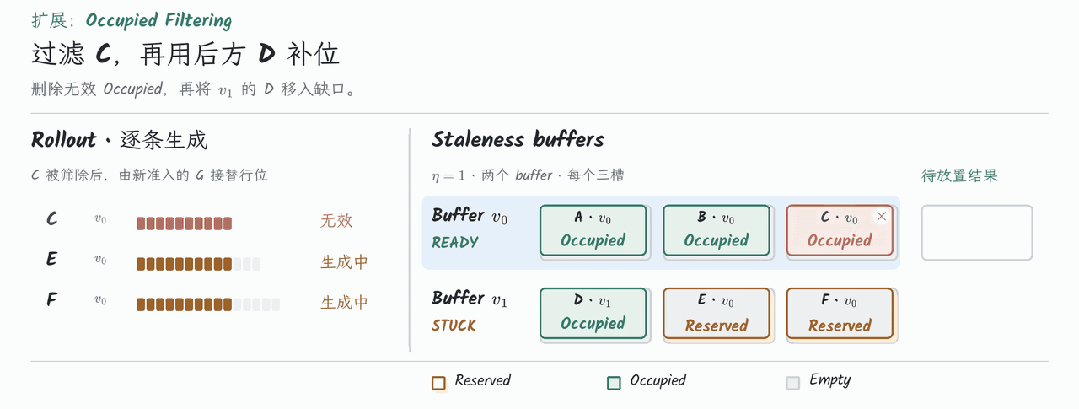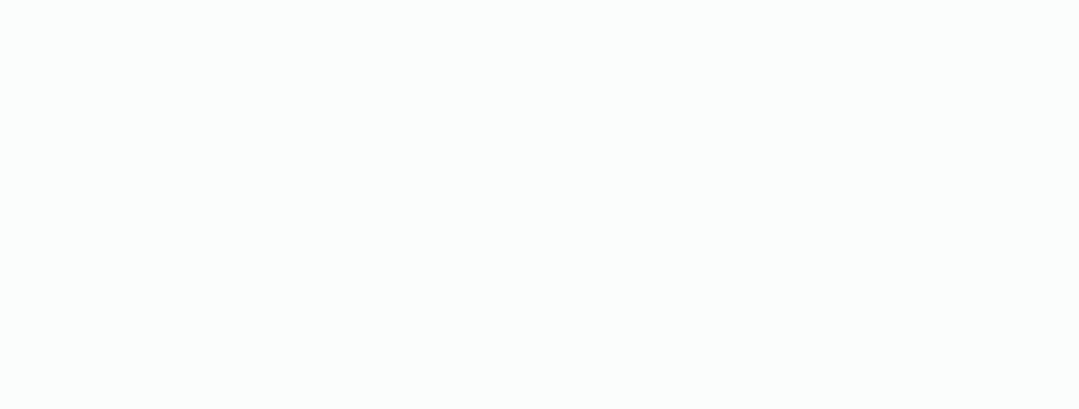
图 13:筛选 Occupied 结果后的补位与准入
(4)GRPO Group
在上面所有例子中,我们的 Reserve 以及 Occupy 都是以 trajectory 为粒度进行的。但在实际中,GRPO 这类算法通常会为一个 prompt 生成多个 trajectory,这样的 trajectory group 中的成员必须全部完成,才可以实际用于训练。在这种情况下,我们将推理和训练中同一 prompt 的一组 trajectory 视作一个基本单位,然后让 staleness buffer 中的一个槽位对应一整个 trajectory group:Reserve 为整个 group 留位置,而 Occupy 则需要等待全组成员和后处理都就绪后再执行。
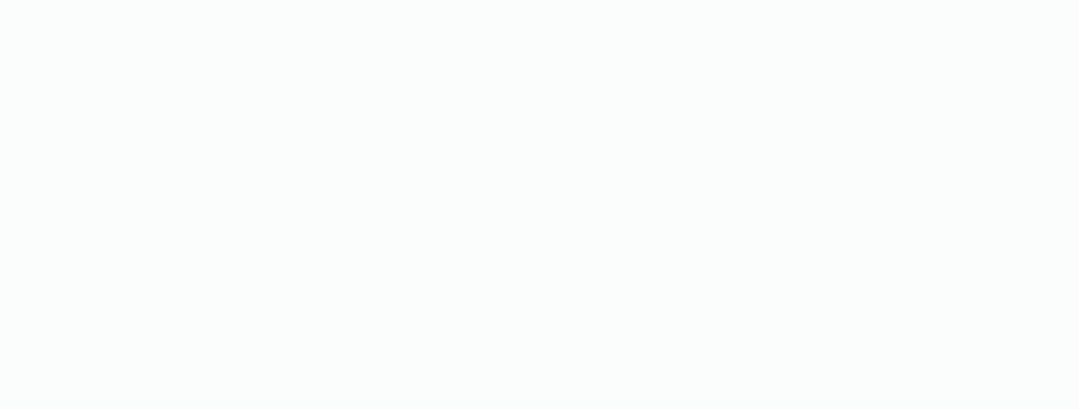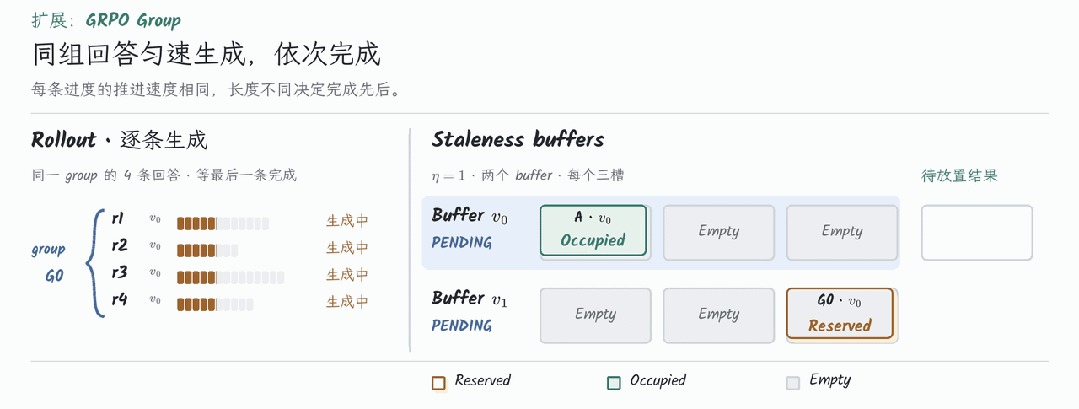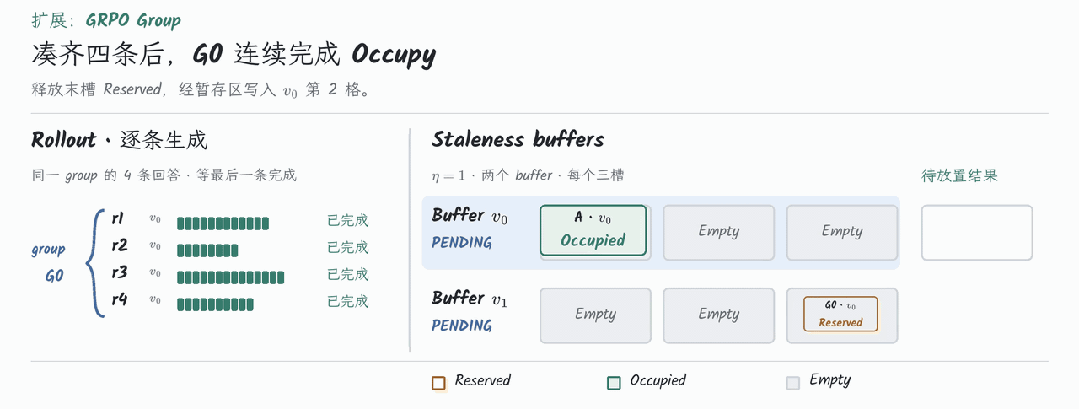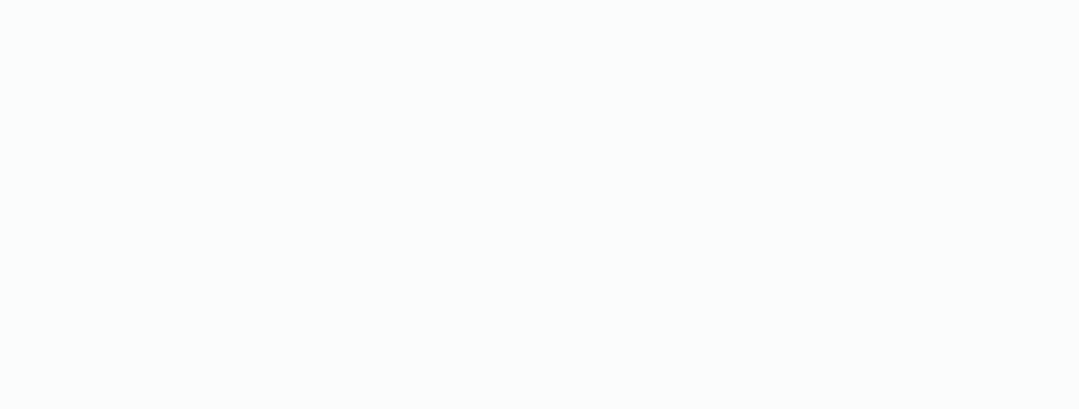
图 14:以整个 trajectory group 为预留和占用单位
(5)Group-level 过采样
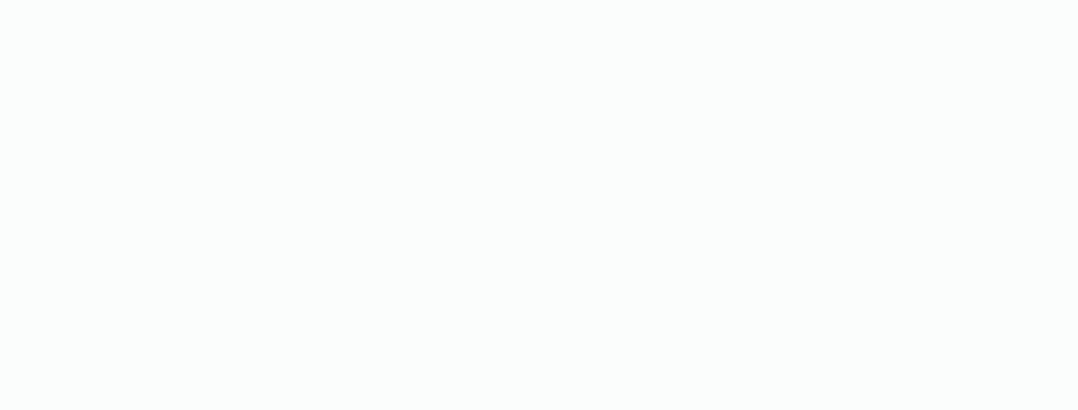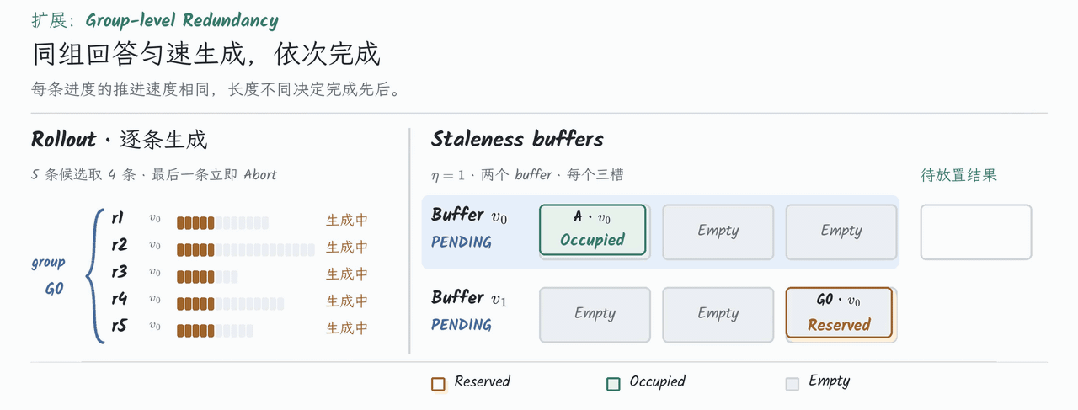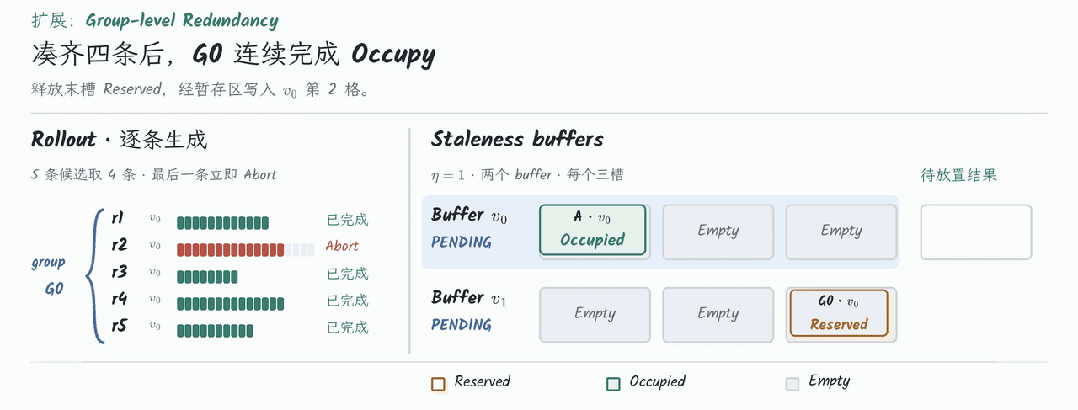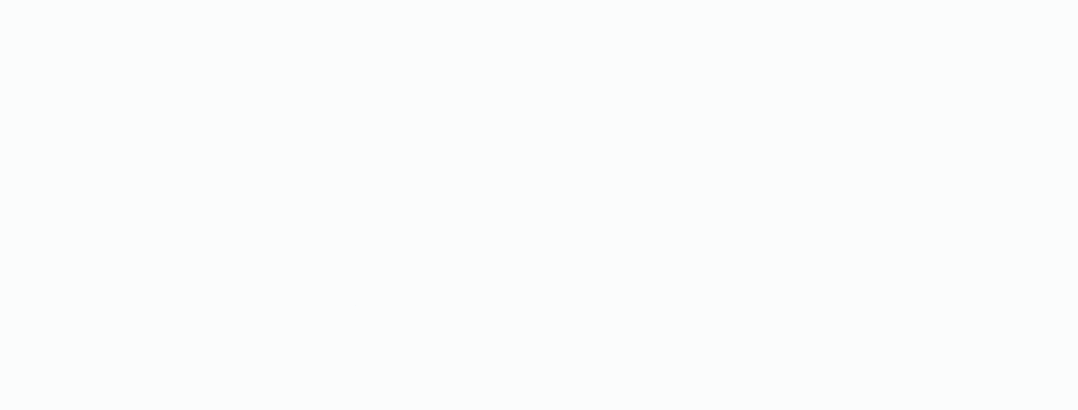
为了减少一个 group 内部的 trajectory 长尾带来的等待,可以为一个 group 同时生成超过所需数量(group size)的候选。只要凑齐 group size,就立刻提交已选成员,剩余候选直接丢弃,不再等待长尾候选生成完成。
(6)Batch-level 过采样
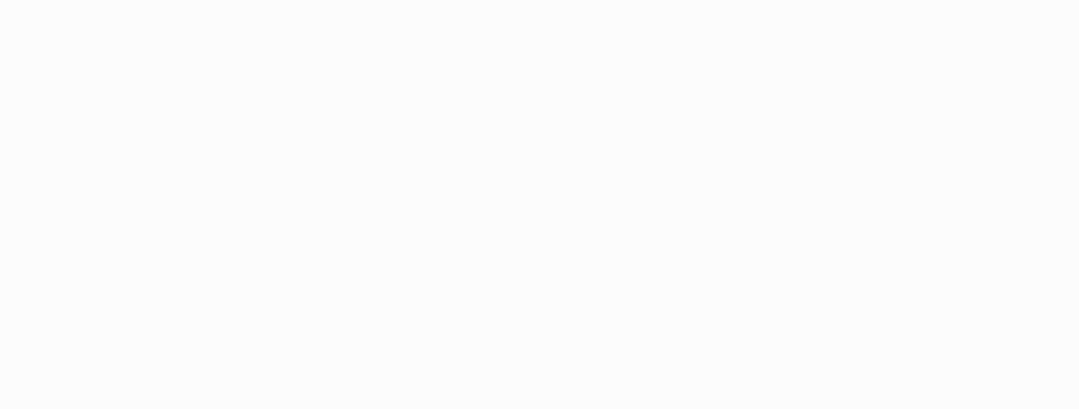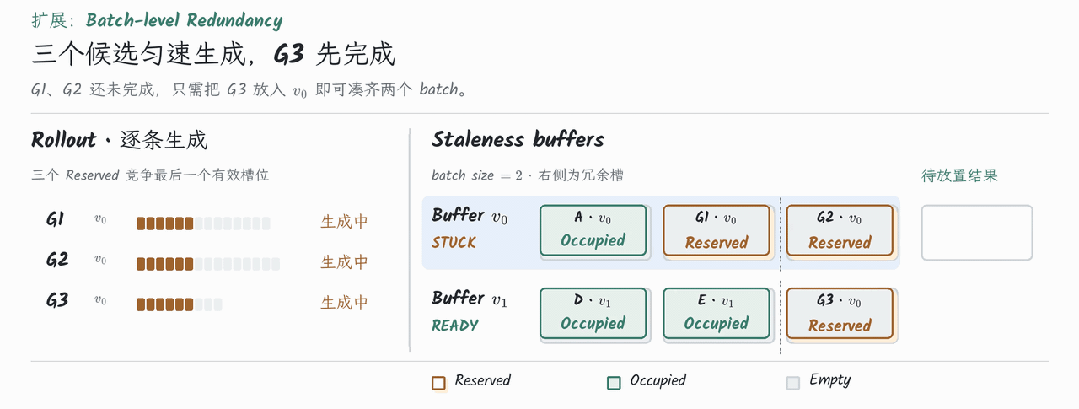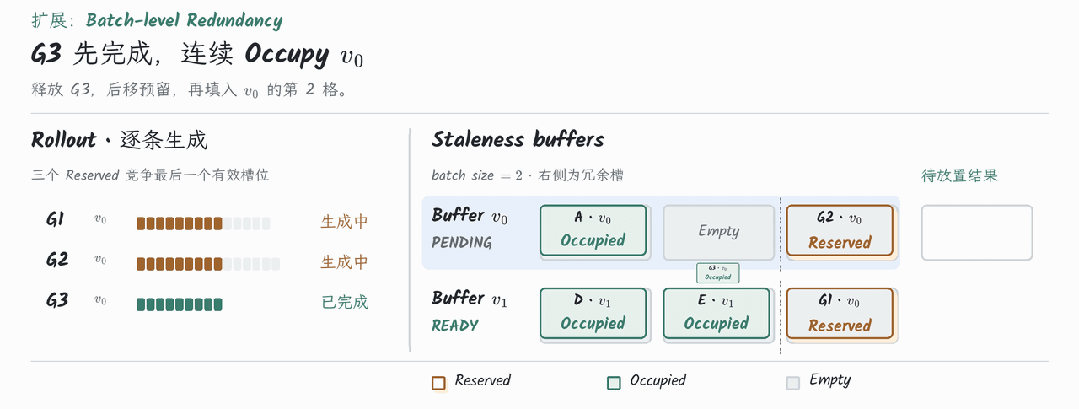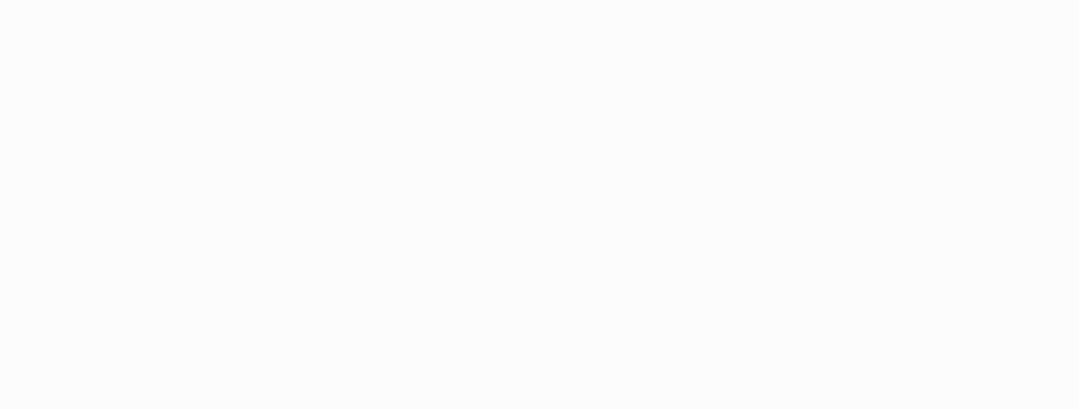
此外,我们也可以生成超过所需 batch 大小(batch size)的 trajectory group,这样可以筛掉 batch 中整体相对长尾的 group。在这种情况下,我们通过增加 buffer 的槽位来实现过采样:实际 buffer 的槽位数会多于训练所需的 batch 大小,而当这些冗余槽位中生成的数据不可能参与到实际 batch 的组建时,我们再将其丢弃。
下面举一个具体的例子:batch 大小为 2,而 buffer 的槽位数为 3。此时,每个 buffer 攒够 2 个 Occupied 就可以变成 READY 并组建 batch 进行训练,而分界线右侧的第 3 个槽位则表示冗余的容量。开始时,v0 有1 个 Occupied 和 2 个 Reserved,v1 有 2 个 Occupied 和 1 个 Reserved。最先完成的候选放入 v0 后,2 个 batch 都达到目标数量,协议会判断剩余 2个 Reserved 产生的数据不可能再有合法的放置位置,因此会一起丢弃,不再参与训练(协议只需要在每次有 buffer 变为 READY 时进行一次判断即可)。
前面,我们已经介绍了 Reserve-Occupy 整套协议的设计。接下来,我们将通过实验验证该协议能否严格控制 staleness,并进一步与其他 RL 框架中的 staleness 控制机制进行对比,分析不同设计带来的性能差异。
要比较这些机制,最直接的办法是把各个框架都部署到真实集群上,再分别调整参数、记录结果。但这样做不仅部署和实验成本高,还会遇到一个更关键的问题:如何保证不同运行之间的可比性?不同框架所用的推理引擎、训练后端和依赖版本各不相同。即使硬件相同,每次运行采到的 response 长度、长尾出现的位置也会变化,而 staleness 恰恰对这些因素十分敏感。这样一来,就很难判断观测到的差异究竟来自控制机制,还是来自执行后端和负载本身。
为此,我们搭建了一套 RL 模拟器SimRL(https://github.com/psrl-project/SimRL),在相同的硬件、模型和负载设置下复现前文讨论的各类控制机制。SimRL 模拟 RL 后训练系统的整套运行逻辑:rollout 侧采用 continuous batching 并进行 KV cache 管理,训练侧通过拟合的成本模型估计每一步耗时,而 L1–L3 的准入、取消和过滤或等待等控制机制则可分别插装配置。这样,我们就能排除其他可能带来干扰的因素,专注于复现 RL 框架的机制本身所产生的影响。
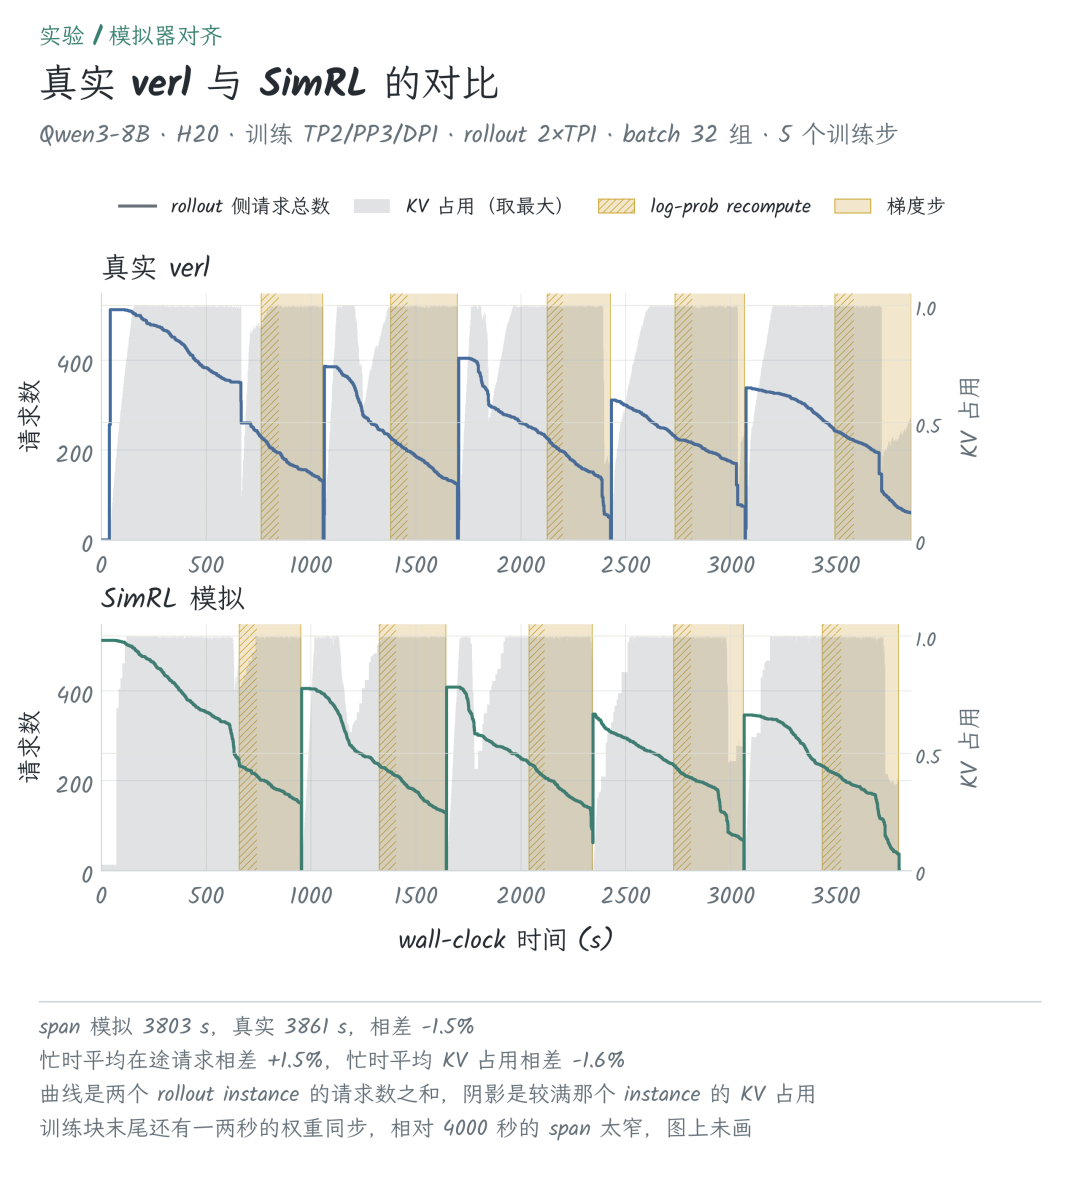
图 17:真实 verl 运行与 SimRL 模拟对比
图中给出了一组相同配置下真实 verl 的运行 trace 与 SimRL 的模拟结果。可以看到,SimRL 对 rollout 侧请求数量和 KV 占用的变化,以及 training 侧耗时的模拟均与实测较为接近,端到端总时长的偏差仅约为 -1.5%。这表明 SimRL 能够较为可靠地反映真实部署中的系统行为。因此,后续实验均在 SimRL 中进行,以统一的模拟环境公平比较不同框架的 staleness 控制逻辑。这里比较的吞吐反映的是不同 staleness 控制逻辑本身的性能差异,并未纳入各框架自身的推理引擎、kernel 实现及其他工程开销,因此不能直接代表各框架在真实集群中的端到端性能。
我们模拟 Qwen3-8B 在一台配有 8 张 H20 的机器上进行 RL 训练。其中,2 张卡用于推理,对应 2 个 rollout instance,各自采用 TP=1。另外 6 张卡用于训练,使用 Megatron,设置为TP=2、PP=3、DP=1。我们采用 GRPO 算法,group size 为 8,每个训练 batch 包含 16个 prompt,也就是 16×8=128条 trajectory,并默认开启 partial rollout。
我们使用来自 dapo-math-17k 真实训练过程的负载 trace,包含 1024 个 prompt group、共 8192 条 response。该负载的 prompt 长度上限设置为 1024 token,response 长度上限设置为 38912 token,具体分布如下。
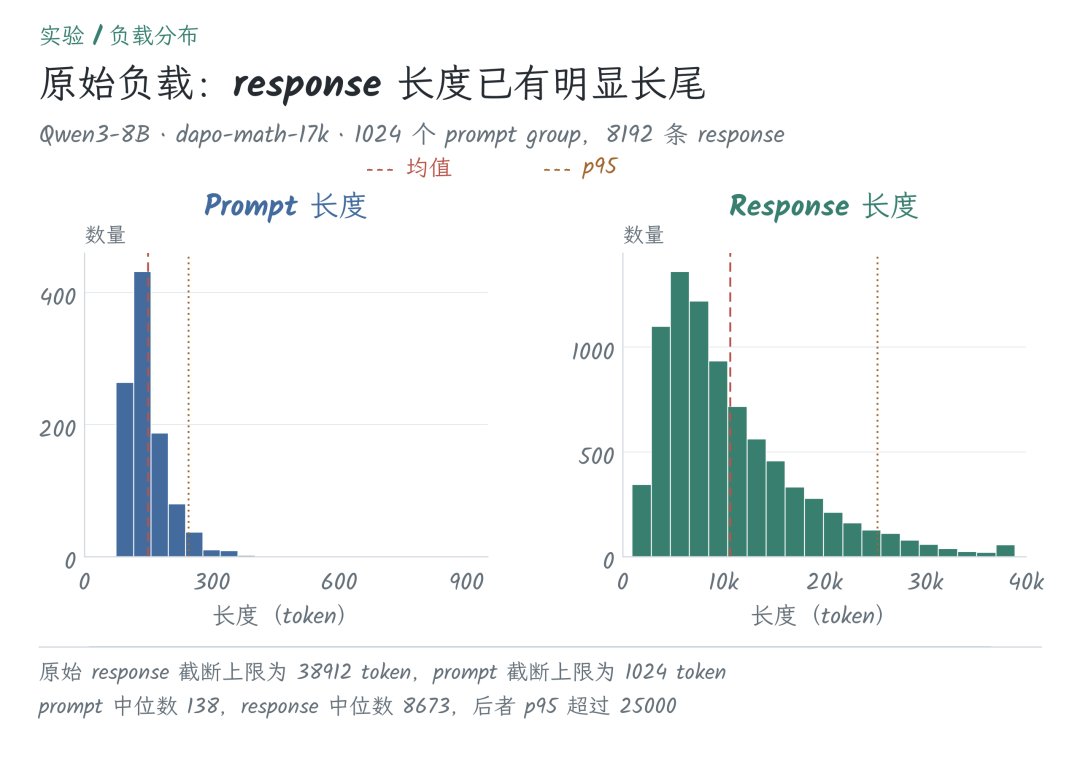
图 18:实验负载的 prompt 与 response 长度分布
3. 正确性验证:协议是否全程不超过 staleness 上限
我们首先验证协议的正确性:给定 staleness 上限η,这套协议能否确保每个训练 batch 中的数据都不超过这一上限?
我们固定每个 rollout instance 的 max concurrency 为 40,然后分别设置 η∈{0,1,2,3,4,5},每种设置运行 100 个训练 batch。下图展示了实验结果:每个子图对应一个η,每根柱子对应一个训练 batch,不同深浅的颜色表示这一批中不同 staleness 的 trajectory 数量。
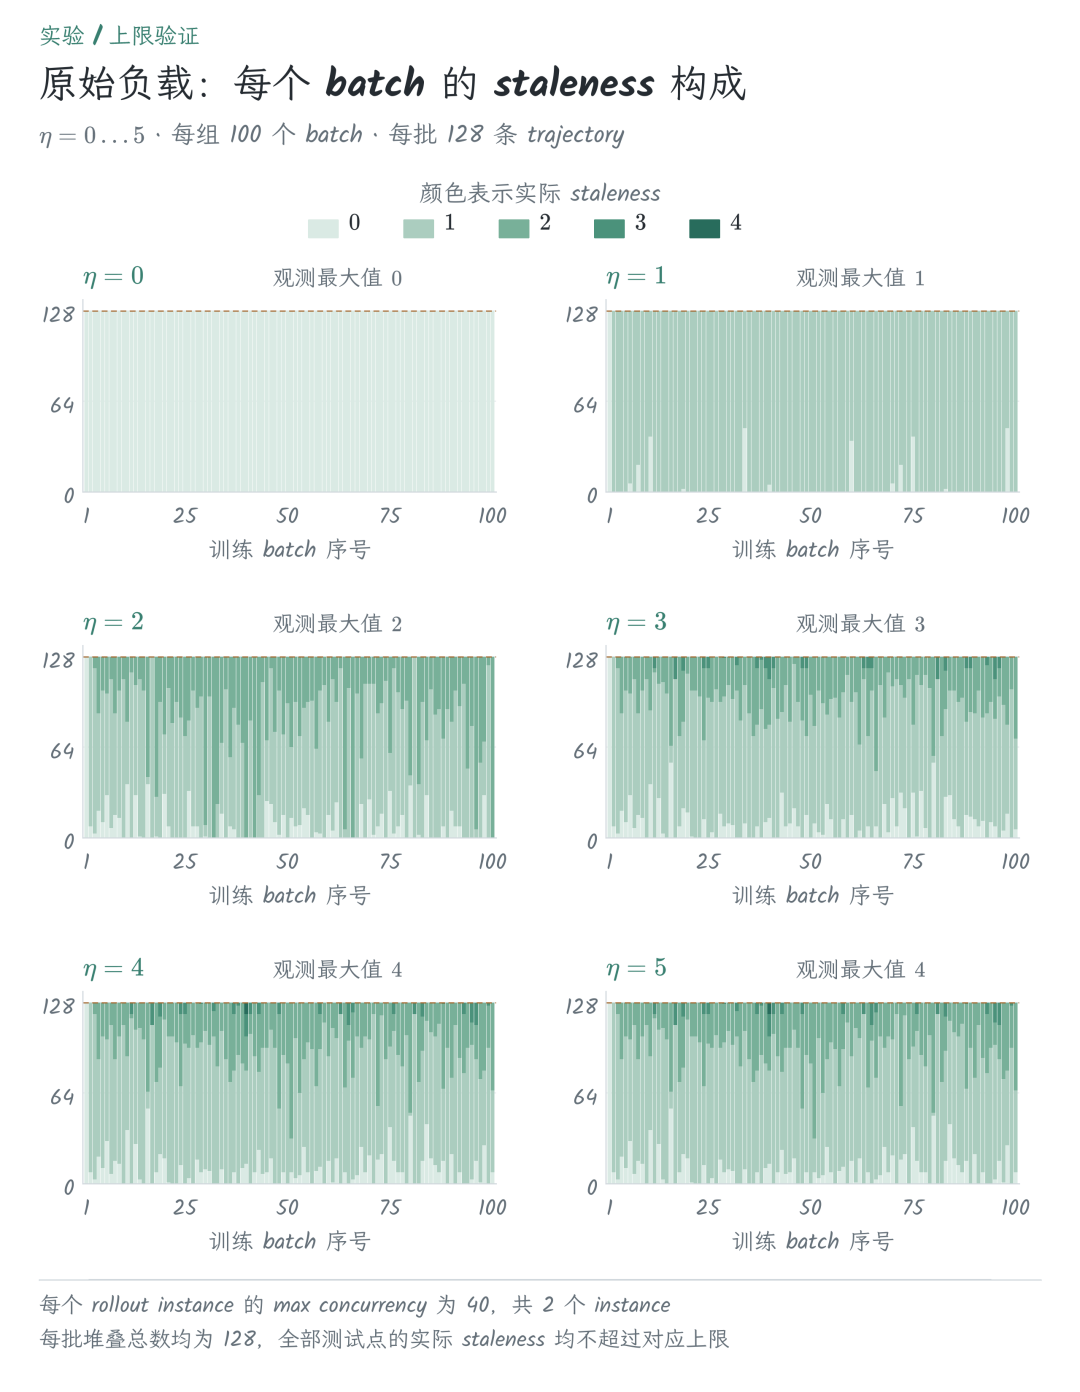
图 19:六种 staleness 上限下的逐 batch 构成
从图中,我们可以看到,每根柱子的总高度始终为 128,说明每个训练 batch 都包含完整的 128 条 trajectory。与此同时,各子图中实际出现的 staleness 都没有超过对应的η。6 种上限、每组 100 个 batch,合计展示的 600 个 batch 中都没有出现超限。
值得一提的是,当 η=5 时,我们观测到的最大 staleness 只有 4。这是因为 η 限制的是数据参与训练时允许的最大版本差,并不意味着数据一定会打满这个上限再参加训练。 只要当前有更早的合法位置,我们的协议就会通过 Occupy 尽早安排这些数据。
这些实验结果与前面对协议的分析一致。在这组实验中,所有训练 batch 都满足 staleness 上限,且协议没有为保证上限而丢弃数据。协议对长尾的保证来自合法预留与放置约束:较慢的 trajectory 始终保有合法位置,必要时由训练等待其完成,而不会被持续后移到超限的位置。
4. 性能验证:相同 max staleness 下的吞吐对比
接下来,我们把这套协议与前文介绍的另外几种同样具有严格 staleness 控制能力的机制放在一起比较。(1)NeMo-RL 的 `in_order` 和 `weight_fifo`:二者都不丢弃超限数据。前者在 L1 准入时绑定训练轮次,并在 L3 训练前停等,确保严格按轮次进行。后者则是严格按权重版本排队并进行训练,因此同样需要在训练前停等。(2)verl 的 `drop` 以及 TRL:二者均在 L1 限制准入,并在 L3 过滤超限结果。(3)ROLL:其在 L1 与 L3 控制的基础上,进一步在 L2 提前淘汰生成中已超限的 trajectory。
本组实验覆盖 η∈{1,2,3},每次模拟 10个训练批次。我们对齐各机制所允许的 max staleness η。特别地,verl 的 L1 准入额度还可以通过 `num_warmup_batches` 单独调节,这里我们固定 `num_warmup_batches` 为默认值 1,不随 η 一起增大。
我们使用有效吞吐作为比较指标,即实际被 RL 训练采用的 token 总数,除以 RL 运行的总时长,单位为 tokens/s。即使某套机制生成了更多数据,其中没有参与训练的部分也不会计入有效吞吐。
在得到的实验效果图中,我们用 Ours 表示我们这套 Reserve-Occupy 协议。柱子的实色部分和顶部数值表示有效吞吐。 上方两种阴影分别表示在 L2、L3 被丢弃的部分,这些部分不计入有效吞吐。绿色倍率则表示我们的协议相对于对应基线的有效吞吐加速比。
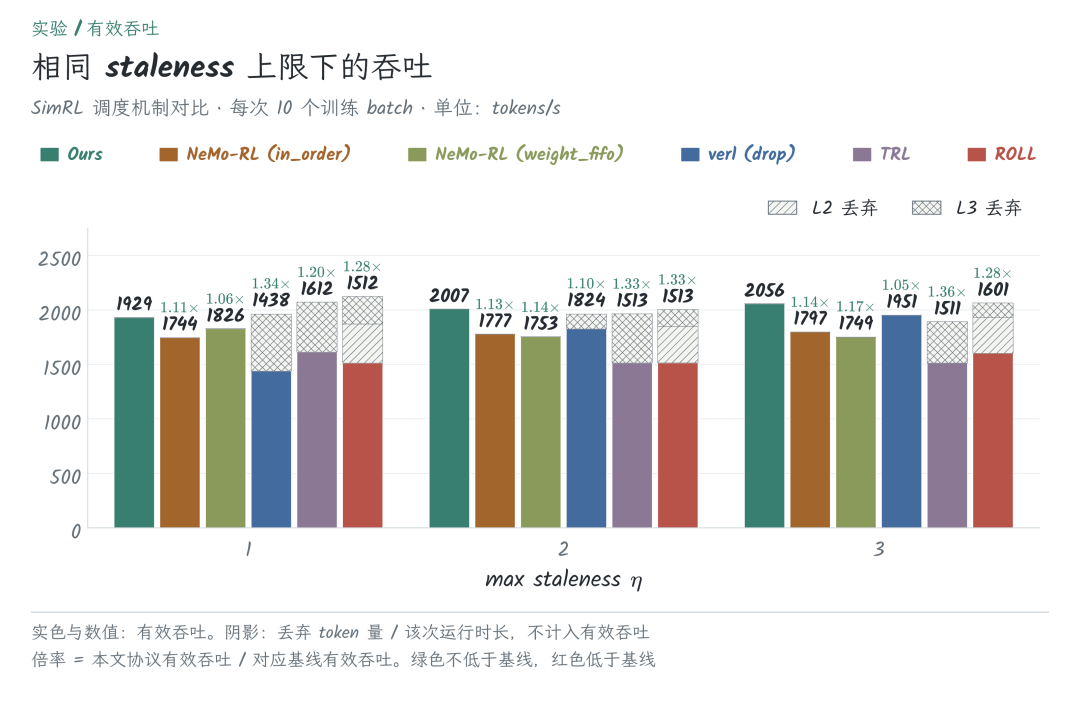
图 20:相同 staleness 上限下的有效吞吐与丢弃开销
首先,我们对比同样不依赖超限丢弃的 NeMo-RL `in_order` 和 `weight_fifo`。在三个测试点上,我们的有效吞吐分别为 1929、2007、2056 tokens/s,约为 `in_order` 的 1.11–1.14 倍、`weight_fifo` 的 1.06–1.17 倍。
这一差距与前文讨论的两套机制的区别相吻合。`weight_fifo` 以及 `in_order` 在生成前就固定了训练 batch,而我们的协议通过 Reserve 为每个 group 保留合法位置,再通过 Occupy 根据实际完成顺序调整放置。这样,完成较快的 group 可以更早凑齐当前 batch,长尾 group 则能在合法范围内后移。因此,相比于固定安排 batch,我们的协议更加灵活,在维持 staleness 约束且不丢弃数据的前提下,为减少训练等待、提高有效吞吐提供了更多空间。
其次,我们对比依赖 L3 过滤的 verl `drop` 和 TRL。η=1 时,verl 有明显的超限丢弃,我们的有效吞吐约为它的 1.34 倍。当 η=2 时,verl 仍有一部分数据在 L3 被丢弃,我们的有效吞吐约为它的 1.10 倍。直到 η=3,verl 才不再出现超限丢弃,吞吐差距也缩小到约 1.05 倍。
而对于 TRL,L1 准入量随 staleness 设置一同扩大,并未被限制为固定值,这导致在所有的测试点上,TRL 都出现了 L3 丢弃。这使得我们的有效吞吐始终具有优势,加速比维持在 1.20 到 1.36 倍之间。
最后,我们对比进一步加入 L2 淘汰的 ROLL。ROLL 可以提前停止已经超限的 trajectory,避免继续生成后续 token,但具体收益依赖于 staleness 上限和具体配置。例如,η=1 时,ROLL 的有效吞吐约为 1512 tokens/s,高于 verl 的 1438,却低于 TRL 的 1612。整体来看,我们的有效吞吐相较于 ROLL 同样有着显着的优势,加速比维持在 1.28 到 1.33 倍之间。
总的来看,在本次所有测试点中,我们这套 Reserve-Occupy 协议的有效吞吐均为最高:我们在准入时为每条 trajectory 保留合法位置,在完成后再根据当前状态调整放置,既避免了超限丢弃造成的浪费,也为更早凑齐训练 batch 留出了空间。
异步 RL 中的 staleness,源于 trajectory 从生成到参与训练期间跨越的策略版本。要严格控制 staleness,真正需要关注的是:实际参与训练的每个 token,其生成版本与训练版本之差是否都不超过给定上限。
沿着 trajectory 的生命周期,我们梳理了 L1 准入、L2 运行时控制和 L3 训练前处理三个介入位置。目前,很多框架仅在 L1 限制准入的并发数或积压量。这虽然能够减少系统中的在途工作,却无法避免长尾 trajectory 跨越多个训练版本,因此并不能真正保证 staleness 上限。
而能够严格控制 staleness 的机制,通常都需要在 L3 引入丢弃或等待。具体来说:(1)一些框架在 L3 直接丢弃超限结果。这是最常见、也最直接的控制方式,但会浪费此前已经投入的生成和计算,并可能改变训练数据的构成。(2)另一些框架则提前固定训练 batch,并在指定数据尚未就绪时等待。虽然这种方式避免了超限丢弃,却也容易让当前 batch 受制于长尾 trajectory,无法充分利用已经完成的其他结果。
因此,为了避免丢弃并保证调度灵活性,我们提出了一套基于 Reserve-Occpuy 的 staleness 控制协议。我们的核心思路是把 staleness 控制转化成了一个放置问题:用 Reserve 在准入时先留好合法位置,用 Occupy 在生成完成后根据实际完成顺序调整放置,训练端再按版本取走完整 buffer。这样,L1 能够感知训练侧剩余的合法位置,L3 在调整数据放置时也始终为尚未完成的 trajectory 保留合法去向。较快完成的 trajectory 可以更早参与训练,较慢的 trajectory 则可以在约束允许的范围内延后,必要时训练也可以等待。
这套协议也可以沿用到 partial rollout 和 GRPO group,并进一步支持异常处理、结果筛选和过采样等扩展。在统一模拟环境的实验中,协议在所测试的预期 staleness 上限下均未出现超限。且与其他具有严格控制 staleness 的机制相比,它在本次所有测试点上均取得了更高的有效吞吐。其为异步 RL 兼顾 staleness 约束与系统效率提供了一条很好的路径。
目前,这套协议已经在我们的 RL 框架 PSRL 中完整实现,欢迎大家试用。对于本文内容或框架使用中的任何问题和建议,都欢迎通过 GitHub Issue 与我们交流。如果这篇文章对你有帮助,还请你顺手给我们项目点个 star⭐,支持我们继续完善框架、分享技术内容。
欢迎关注本公众号,帮助您更好地了解北京大学数据与智能实验室(PKU-DAIR),第一时间了解PKU-DAIR实验室的最新成果!
北京大学数据与智能实验室(Data And Intelligence Research Lab at Peking Univeristy,PKU-DAIR实验室)由北京大学计算机学院崔斌教授领导,长期从事数据库系统、大数据管理与分析、人工智能等领域的前沿研究,在理论和技术创新以及系统研发上取得多项成果,已在国际顶级学术会议和期刊发表学术论文200余篇,发布多个开源项目。课题组同学曾数十次获得包括CCF优博、ACM中国优博、北大优博、微软学者、苹果奖学金、谷歌奖学金等荣誉。PKU-DAIR实验室持续与工业界展开卓有成效的合作,与腾讯、阿里巴巴、苹果、微软、百度、快手、中兴通讯等多家知名企业开展项目合作和前沿探索,解决实际问题,进行科研成果的转化落地。