刷屏全球的AI 新顶流Jev,一句话都不说,到底怎么玩?
本文来自微信公众号: APPSO ,作者:发现明日产品的
各类新模型层出不穷,恨不得向全世界证明自己能写、能聊。然而,近期风头最劲、刷屏全网的顶流,却是Jev。
它并不说话。
Diogo Almeida是OpenAI的研究员,他参与了ChatGPT的研发工作,后来又提出了基于人类反馈的强化学习算法(RLHF)。
这在某种程度上定义了过去几年大语言模型的走向。可是就在这套方法把整个行业推向繁荣的同时,Almeida却对它越来越怀疑。
「我们有了一次性成功的创新,但没有把它变成真正有用的东西。」
他花了很长时间才想明白问题出在哪里:我们一直在优化人类语言的处理能力……在四年的时间里,我们在处理人类语言方面表现得非常出色,但这对于自动化来说并没有用处,因为计算机使用的是不同的「语言」。
两年前,Almeida离开OpenAI,和Erik Gafni、Sasha Sheng一起创办了TypeSafe AI。公司一直处于隐身状态,直到9月15日才正式亮相,同时带来两样东西,一是4000万美元的种子轮融资,由DCVC领投,二是他们的第一个模型Jev。
Jev依然是一个基于Transformer的模型,但它刻意不是大语言模型,不会输出一个完整的句子。
你给它一段程序状态和一个预先定义好的问题,它返回的是一个类型化的答案,一个选项,一个分数,或者一个介于0和1之间的概率,外加一个置信度评分。
TypeSafe把这种输出称为「校准后的决策」。这也是Jev这个名字第一次进入公众视野时,很多人第一反应是困惑的原因。
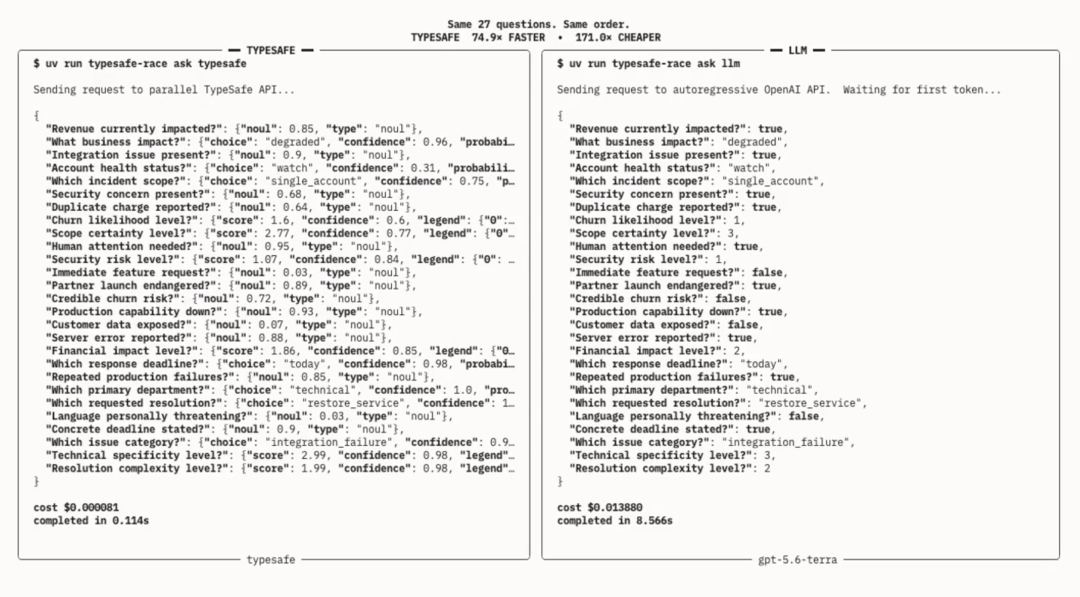
截图展示了Jev与大语言模型在应对相同请求时的表现对比
AI圈最火的模型,跟ChatGPT不是一个路子
要理解Jev在做什么,不妨先放下大语言模型的思维习惯。
换成一个客服场景就好理解了。用户发来一条消息:支付服务连续几天连不上,已经影响生意。此时需要做几个判断:该交给技术还是账务团队,对方有多不满,事情是不是紧急。
按TypeSafe的接口设计,同一次请求中的问题共享一份输入,却是独立、并行评估的。分类和紧急程度可以一起处理。

具体来讲,其输出有三种基本形态。第一种叫Choice,从一个你定义好的列表里选出一项,最多支持255个选项,适合做路由和分类。第二种叫Score,把输入放在一个你划定的尺度上打分,用来衡量紧迫程度、质量或者风险。第三种叫Noul,本质上是一次是非判断,答案是一个数字,代表这件事为真的概率。
每一次回答都会附带完整的概率分布和置信度,是强类型的结果,不需要写JSON提示词,不需要额外的解析器,也不用担心模型突然给结果包一层Markdown代码块。

采用这种方式,最直接的好处是省时、省钱,也减少了自由生成带来的格式错误。
TypeSafe公布的数字显示,Jev的端到端延迟在70到500毫秒之间,比同类大语言模型快20到200倍。

按当前的公开价格,输入每十亿token为42美元,换成常见口径,就是每百万token 0.042美元;输出不收费。新增的问题和选项说明仍会占用输入token,只是不再按生成答案的长度另收一笔费用。

由于用户可以提前定义输出结果,因此模型不会产生幻觉。(Jev不会产生幻觉,指的是它不会跳出预先设定的选项范围乱答,但选项范围之内答错依然是可能的。)

在一场公开的Ably Pong演示中,Jev在12秒内做出了47次操作决策,而Gemini、Claude和GPT在同样时间里只做出两三次,尽管后者在大多数情况下依然给出了正确判断。
在Ably Pong演示里,程序直接把游戏里的数字交给Jev:球的位置、运动方向、球拍的位置,以及球预计到达球拍所在位置时的纵坐标。Jev可以根据这些数字,从「向上、向下、保持不动」三个选项中选一个。

Jev的打开方式有哪些
想借助Jev做成可玩的产品,需要游戏程序和实时通信。上述项目由后端负责推进游戏、调用模型,再通过Ably把新状态发给浏览器。也就是说,游戏规则、画面和联网都不是Jev生成的,它只被插进了那个反复执行的三选一环节。
速度换来的是应用场景的扩展。Jev可以充当电脑操作的判断层,指导代理快速执行指令;也可以用来做上下文压缩,判断哪些内容是关键信息,从而把上百万token的上下文迅速收窄。
Browser Use的公开项目jev-ultrafast,具体实现的是浏览器代理。它每到一个网页,先读取当前可操作的页面元素,整理成带编号的清单:哪个是按钮,哪个是输入框,叫什么名字,现在填了什么。
Jev得到的是这份结构化状态、用户目标以及操作历史。程序给它的选择空间,也由当前页面实际存在的元素动态生成。
将Jev用作操作判断层,指导模型快速操作你的电脑https://x.com/gregpr07/status/2100411066966749359
以查机票为例,目标可以是「查找苏黎世到伦敦的单程航班,设置指定日期、人数和舱位,出现符合条件的结果后停止」。
每一轮,程序会同时问几个问题:下一步应该点击、输入、选择下拉选项,还是等待?假如点击,应该点哪个编号?假如输入,应该填哪个编号?这些问题共用同一份网页状态,但分别作答。
最后程序只采用与实际操作匹配的目标:选择了点击,就使用点击目标,其他答案暂时不用。
碰到需要输入城市名称的时候,程序会另行调用一个生成文本的小模型,让它根据目标和当前输入框给出要填写的内容。浏览器执行之后,再读取页面的新状态。

由Jev判断上下文内容的重要信息,实现近乎即时的上下文压缩https://x.com/tamarajtran/status/2100694549362553153
Vercel公司的软件工程师Pranit Sharma表示,他的公司使用了OpenAI的ChatGPT Luna 5.6来运行分类器,以检查命令的安全性。当Vercel用Jev替代了OpenAI的Luna后,处理速度提高了5到18倍,准确性也大大提升了。
另一位开发者Bryo AI的CTO Nikhil Mudholkar也对Jev和Gemini进行了测试,目的是评估它们在分类商业邮件方面的表现。在他的测试中,Gemini的准确率略高一些,但成本则高出10到20倍。
我们也可以按这个思路自行搭建,可以先准备一张表,每行包含邮件标题、正文、收到时间和必要的上下文。
然后把业务拆成几道明确的问题。例如,一封邮件写着「订单被重复扣款,希望今天处理」,可以用Choice判断应该进入售后、销售、合作还是其他队列;用Noul判断发件人是否明确要求采取行动;再用Score判断处理优先级。
「归根结底,这种方式将幻觉问题的处理责任稍微转移到了用户身上,」Earendil公司的CTO Armin Ronacher解释道。「用户需要决定:如果这种情况出现的概率只有50%,那或许可以忽略它。但如果概率达到95%,那我就可以利用它了。」
Ronacher表示,Jev的另一个潜在应用是模型路由。预测某个任务是否需要特定模型是很有用的,但使用大型语言模型来完成这一任务会非常昂贵。而Jev的成本低廉且运行速度快,因此能够实现这种实时的路由功能。
根据任务复杂程度自动分配合适的模型来处理https://x.com/mdlahfir/status/2100314182201802811
最明智的决定
Jev这个名字取自19世纪的经济学家William Stanley Jevons。Jevons提出的悖论指出,当某种商品的成本下降时,这种商品会被越来越多地使用。在这种情况下,智力的成本下降应该会导致智力的广泛应用。
也就是说调用一旦变便宜,就会被用在更多原本不值得动用的地方。Almeida显然对这个类比很满意,他设想的未来不是几个庞大的应用垄断一切,而是大量微小的智能判断分散在各处运行,「更像早期互联网的样子,而不是现在人们努力搭建的那种大型应用」。
TypeSafe至今没有公开Jev的具体架构,外界普遍猜测它是在某个开源大语言模型的基础上改造而来。
公司自己将其称为System One Models,取自卡尼曼关于直觉思维的概念,强调它靠的是直觉判断而不是推理链条,并且是针对具体任务专门调校出来的。
官方建议把复杂判断拆成几个明确的问题,再由代码组合,而不是一股脑让模型包办。
Almeida透露,他很早就预判到自己会走上处理合成数据这条路,这或许是他这辈子做过最明智的决定,比公司上市还明智,甚至比依赖真实人类反馈还明智。
目前市面上采用这种路线的公司只有TypeSafe一家,但Ronacher预计,随着这种模式的实用价值逐渐被验证,跟进者会陆续出现。TypeSafe自己也计划围绕不同场景推出更多版本的模型。
被问到公司是否算得上一家前沿实验室时,Almeida说:「前沿实验室的主要产物要么是恐惧,要么是炒作,我希望我们的主要产品是智慧,我们不属于那种一门心思创造无限财富,或者搞宗教式叙事,或者试图在数据中心里造神的实验室」。
Jev上线后,需求量一度超出预期,API短暂无法正常响应。有人用它做小众信息流的筛选,读取过去三天的相关帖子,提出八个问题,运行时间约两秒,单次成本0.007美元,用来剔除诱饵内容和隐藏广告。
也有团队把它接入整套营销分析流程,扫描Meta广告库、比较不同广告格式的存活周期、在拍摄前评估创意脚本的竞争力,把原本需要人工完成的判断提速了30倍,成本压到3美元以内。
AI少说了很多话,软件却多做了几件事。